DeepSeek V4 Pro (1.6T-A49B) et Flash (284B-A13B) : bases et instruct disponibles sur puces Huawei Ascend
DeepSeek publie son premier grand modèle depuis V3 et R1, un MoE de 1,6T paramètres entraîné sur 32T tokens avec context de 1M tokens.
Sources : Latent Space (Swyx) (source primaire), NVIDIA Developer Blog, MIT Technology Review · IA, DeepSeek (Hugging Face)
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Fiche DeepSeek V4 Pro : prix API, sorties et articles
Fiche DeepSeek-V4 : prix API, sorties et articles
Fiche DeepSeek-V4-Flash : prix API, sorties et articles
Développement
· Généré par Claude Sonnet 4.6↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
DeepSeek publie la collection V4 après plusieurs mois de retard, marquant le premier renouvellement majeur d'architecture depuis DeepSeek-V3 (décembre 2024) et DeepSeek-R1 (janvier 2025). La famille se compose de deux modèles : V4 Pro, un MoE de 1,6 trillion de paramètres avec 49 milliards actifs, et V4 Flash, plus compact avec 284 milliards de paramètres et 13 milliards actifs. Les deux sont publiés sous licence MIT, en versions base (pre-trained) et instruct, sur Hugging Face, avec un rapport technique de 58 pages salué par de nombreux chercheurs comme l'un des documents les mieux rédigés de l'année dans le domaine.
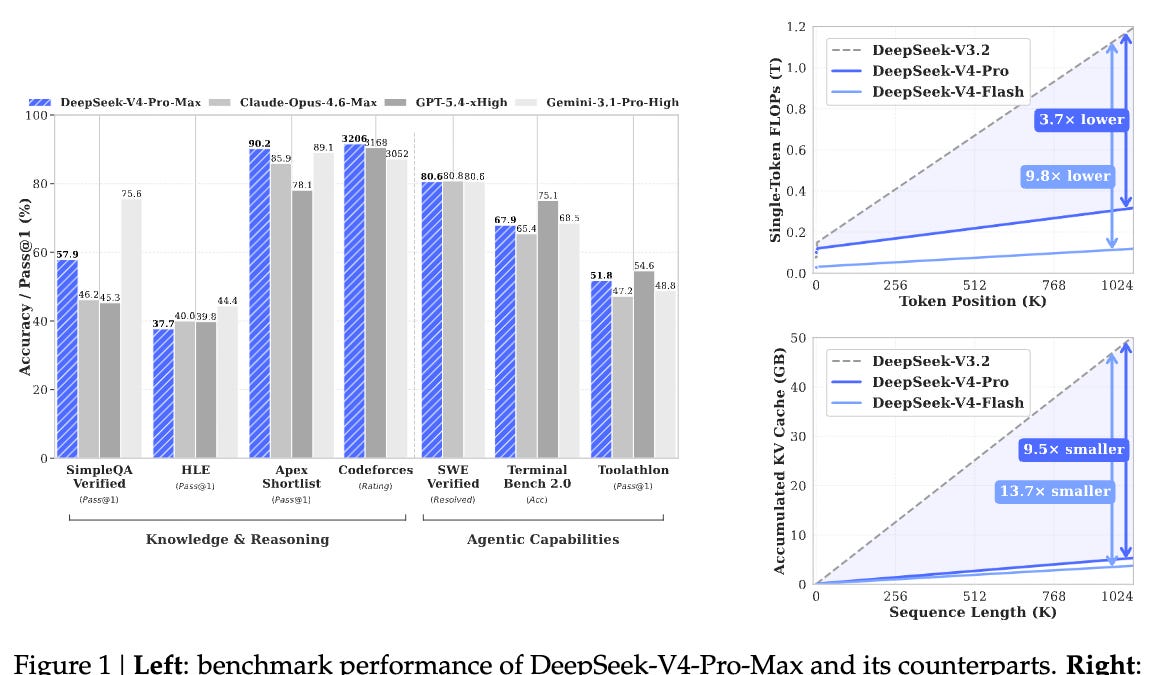
Le chiffre technique le plus remarqué est le contexte de 1 million de tokens, en hausse depuis les 128 000 tokens de V3.2. Cette extension est rendue possible par deux nouvelles techniques d'attention : la Compressed Sparse Attention (CSA) et la Heavily Compressed Attention (HCA). Le système fonctionne par couches combinant des vecteurs KV partagés, des flux KV compressés à des facteurs de 4× et 128×, une attention sparse sur ces tokens compressés, et une fenêtre glissante locale de 128 tokens. Le résultat concret : un cache KV de 9,62 GiB par séquence en bf16, contre 83,9 GiB pour V3.2, soit une réduction de l'ordre de 8,7×. Combiné à l'indexation FP4 et au cache d'attention FP8, le système atteint environ 10× de réduction globale du cache KV, tout en ramenant les FLOPs d'attention à 10–27 % de ceux de V3.2 à contexte équivalent. Le pre-training a mobilisé 32 à 33 trillions de tokens avec une précision FP4, et le checkpoint complet tient sur un nœud 8×B200.
Sur le plan des performances, les évaluations indépendantes placent V4 Pro en deuxième position parmi les modèles open-weights raisonnants, derrière Kimi K2.6 (score 54 sur l'Artificial Analysis Intelligence Index contre 52 pour V4 Pro Max). En performance agentique sur l'indice GDPval-AA, V4 Pro obtient 1554, devant Kimi K2.6 (1484) et GLM-5.1 (1535). Le consensus reste que le modèle se situe en deçà des meilleurs modèles propriétaires fermés — GPT-5.4, Gemini 3.1 Pro, Opus 4.7 — avec un écart estimé à environ quatre à cinq mois. Le taux d'hallucination mesuré reste élevé : 94 % sur AA-Omniscience pour Pro, 96 % pour Flash. Par ailleurs, les évaluations révèlent une consommation de tokens très importante — 190 millions pour Pro et 240 millions pour Flash sur le benchmark AA — ce qui relativise l'attractivité du pricing affiché (1,74 $/3,48 $ par million de tokens input/output pour Pro ; 0,14 $/0,28 $ pour Flash).
La question géopolitique occupe une place centrale dans la réception du modèle. La compatibilité native avec les puces Huawei Ascend (CANN) est explicitement présentée comme une étape vers l'indépendance vis-à-vis des GPU Nvidia soumis aux contrôles américains à l'export. DeepSeek a indiqué que les prix pourraient baisser significativement une fois les supernœuds Ascend 950 déployés à grande échelle au second semestre 2026. Les Ascend représentent encore environ un quart de l'offre disponible en H100, mais l'intégration day-0 dans vLLM, ainsi que les benchmarks publiés par SemiAnalysis sur H200, MI355, B200 et GB200, attestent d'un écosystème d'inférence qui se structure rapidement autour de V4.
Un débat de fond divise les observateurs : V4 constitue-t-il une avancée en qualité de modèle, ou son apport principal réside-t-il dans la conception systèmes pour le long contexte ? Plusieurs chercheurs estiment que l'architecture CSA/HCA fixe un nouveau point de référence pour les MoE open-weights à contexte long, indépendamment des scores de benchmark. D'autres soulignent que la complexité du système — hyperparamètres nombreux, co-design mémoire/attention, exigences d'infrastructure — rend difficile la reproduction par la plupart des laboratoires, nuançant l'idée d'une véritable démocratisation. V4 Flash, en revanche, est jugé potentiellement plus structurant pour l'adoption pratique : il tourne sur un Mac doté de 256 Go de RAM, se positionne sur la même intelligence que Sonnet 4.6 à une fraction du coût, et affiche des performances raisonnantes proches de Pro en mode max selon plusieurs évaluateurs. La publication simultanée des versions base et instruct ouvre par ailleurs la voie à de futurs travaux de post-training, notamment un éventuel DeepSeek R2.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- PleIAs publie Baguettotron-MoE, un LLM français à architecture MoE sur Hugging FacePleias · 1 octobre 2026
- Muse Spark Open : le modèle MoE multimodal open-weight de Meta, à la frontière de l'état de l'artHugging Face · 15 octobre 2026
- PleIAs publie Baguettotron-600M, un LLM open-weights de 600 millions de paramètres entraîné sur du françaisPleias · 1 octobre 2026
- DeepSeek V4 : presque au niveau frontier, à une fraction du prix24 avril 2026
- DeepSeek publie DeepSeek-V4-Pro-Base sur Hugging FaceDeepSeek · 27 avril 2026
- DeepSeek lance DeepSeek-V4-ProDeepSeek · 13 mai 2026