Les messages en langage naturel entre agents LLM sont un anti-pattern architectural
Un développeur argue que faire communiquer des agents LLM via du texte libre est une erreur de conception, et propose une alternative structurée.
Traduit et résumé par IA à partir de l'article de novaberg.de ↗ · Comment Fellow travaille
Développement
· Généré par IA↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
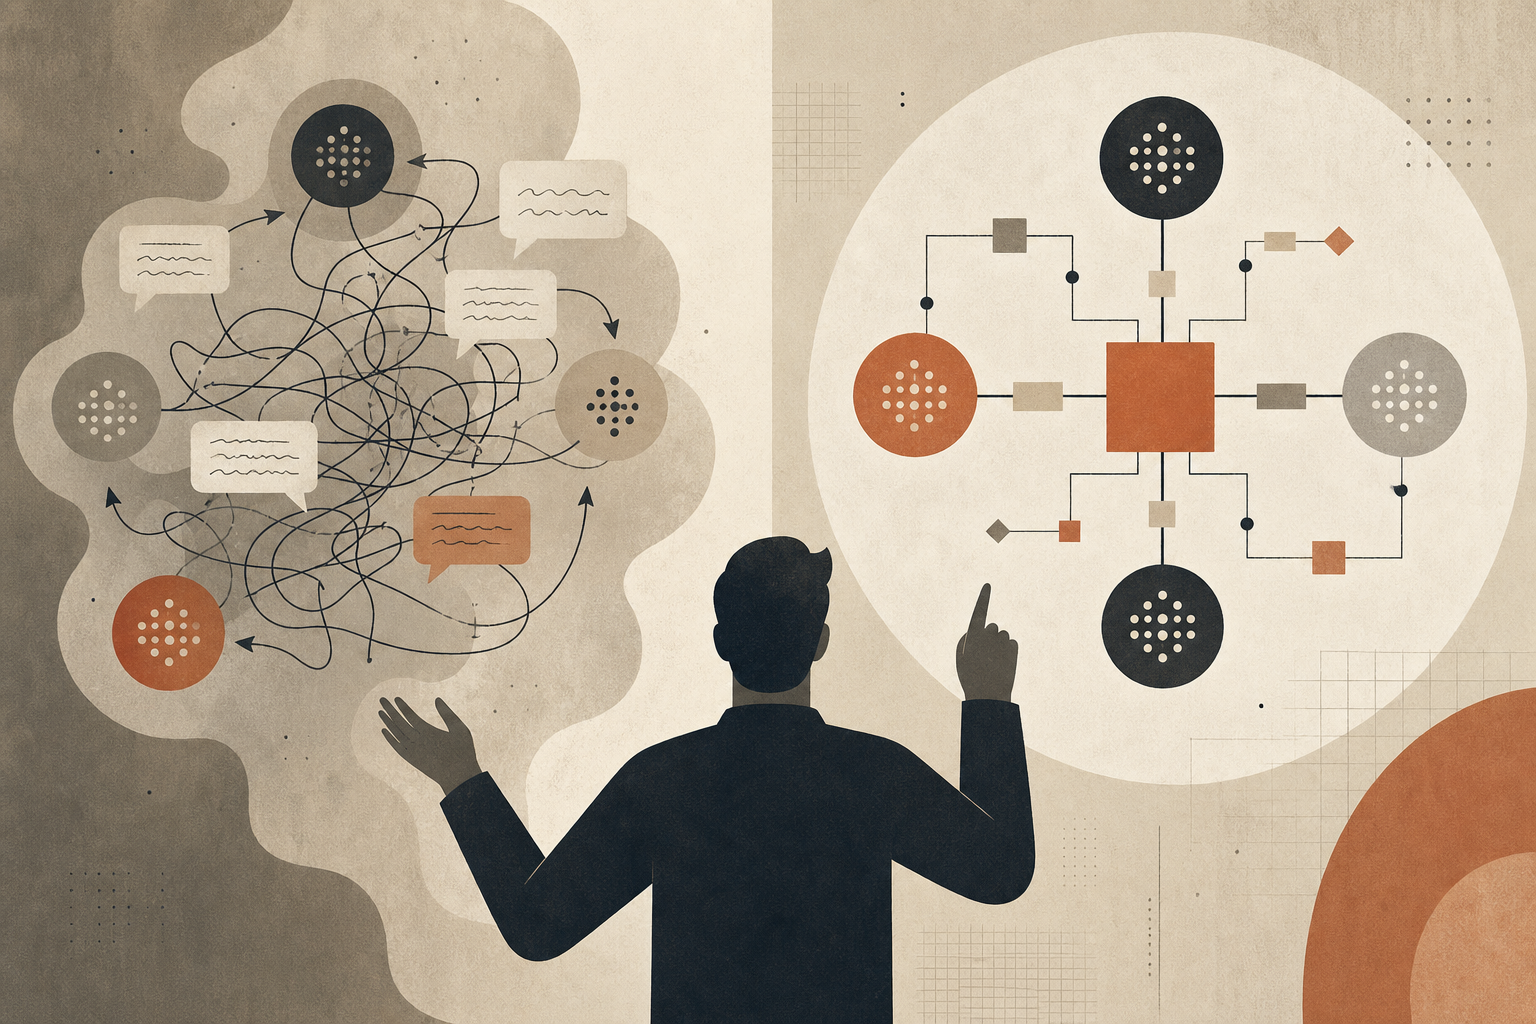
Dans la majorité des frameworks multi-agents populaires — CrewAI, AutoGen, les templates LangChain — la communication entre agents repose sur des échanges en langage naturel : la sortie textuelle d'un agent devient le prompt du suivant. Claus Schlehhuber, développeur indépendant, qualifie cette pratique d'anti-pattern architectural et propose une alternative nommée « clipboard pattern ».
L'argument central tient en une formule : chaque étape de ré-encodage en langage naturel est une compression avec perte. L'agent récepteur ne reçoit pas les données brutes, il reçoit une reformulation teintée du vocabulaire, des priorités et des biais d'entraînement de l'agent émetteur. Après deux ou trois sauts, ce que Schlehhuber appelle la « dérive sémantique » peut avoir effacé des informations critiques — comme une clause de résiliation disparue dans le résumé d'un compliance officer avant d'atteindre un agent de revue juridique. L'architecture, et non l'agent, est alors en cause.
Trois autres dommages s'accumulent selon l'auteur. Le coût en tokens d'abord : un champ typé `confidence: 0.83` consomme un token là où une formulation naturelle équivalente en mobilise quinze à l'écriture et autant à la lecture, sans apporter davantage d'information. L'impossibilité de tester ensuite : une entrée et une sortie en texte libre rendent les assertions unitaires fragiles, dépendantes du comportement stochastique du modèle. Enfin, la traçabilité : un journal d'échanges textuels constitue techniquement une piste d'audit, mais pratiquement un site archéologique où reconstituer une décision relève de l'interprétation.
Le clipboard pattern répond à ces quatre problèmes par un objet d'état typé unique — un `TypedDict` dans l'implémentation LangGraph proposée — qui circule séquentiellement entre les nœuds spécialisés. Chaque nœud lit les champs dont il a besoin, écrit dans ses propres champs, et transmet l'état au suivant. Aucun message ne transite entre agents. La métaphore convoquée est celle du dossier judiciaire : il passe de bureau en bureau, chaque intervenant y ajoute sa contribution sans jamais résumer le travail de ses collègues dans ses propres mots.
L'implémentation décrite s'appuie sur une taxonomie à trois niveaux. Les rôles désignent des fonctions récurrentes dans tout agent de workflow : Classify (traduit la requête naturelle en vocabulaire métier), Resolve (localise l'entité cible), CRUD (exécute l'opération), Resume (reprend après une clarification), Confirm (formule le résultat pour le composant de réponse). Les départements regroupent ces rôles autour d'un domaine — notes, agenda, identité du personnage — chacun livré avec son propre fichier `dispatch.py` assurant la traduction entre l'état global `ConversationState` et l'état interne du département. Les graphs, enfin, sont les unités cognitives qui orchestrent plusieurs départements en workflows : dans le projet Novaberg, un `HumanGraph` perçoit et persiste le tour utilisateur, un `CharacterGraph` produit la réponse, découplés par une file Redis.
Ce que ce découplage rend possible est concret : un nœud de planification est une fonction `State → State` déterministe, testable par fixtures, rejouable à partir d'un snapshot. LangGraph persiste l'état entre chaque nœud, ce qui transforme un incident de production en séquence rejouable en débogueur plutôt qu'en transcript à interpréter.
L'auteur reconnaît explicitement les limites du pattern. Pour des usages où la conversation émergente entre agents est fonctionnellement utile — brainstorming, débat, négociation — le clipboard pattern n'est pas l'outil adapté. Son argument est que la majorité des systèmes présentés comme « multi-agents » sont en réalité des pipelines, et que qualifier un pipeline de conversation ne fait que le rendre coûteux sans le rendre plus fiable.
La proposition n'est pas neuve dans son principe — Schlehhuber cite le flux de données unidirectionnel de React, la discipline de messagerie structurée d'Elixir/OTP, les travaux Graphiti/Zep sur la mémoire structurée — mais elle est la première à nommer et codifier explicitement le pattern dans le contexte des systèmes LLM multi-agents. Le code source du projet Novaberg est publié sous licence Apache 2.0 sur Codeberg. La question ouverte que laisse l'article est précisément celle des cas mixtes : les systèmes où une partie du workflow bénéficierait d'émergence conversationnelle et une autre de garanties structurelles, et comment articuler les deux substrats sans reproduire les problèmes de couplage que le clipboard pattern cherche à résoudre.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- GBClaw : un framework d'IA agentique pour la recherche atomistique sur les joints de grains et la découverte de mécanismes20 octobre 2026
- Cela peut-il fonctionner ? Synthèse de mécanismes CAO fonctionnels19 octobre 2026
- MemT-1.0 : vers une évolution native de la mémoire dans les modèles de fondation19 octobre 2026
- Cache-to-Cache : une communication sémantique directe entre LLMs18 septembre 2026
- OpenArch : implémentations PyTorch d'architectures LLM modernes14 septembre 2026
- Le routeur intérieur : révéler le routage natif de compétences d'un LLM figé14 septembre 2026