OUTILS
Dans les entrailles de vLLM : anatomie d'un système d'inférence LLM à haut débit
Une analyse technique détaillée de l'architecture de vLLM, moteur d'inférence open-source devenu référence pour servir des LLM à grande échelle.
aleksagordic.com·repéré via Hacker News·6 août 2026
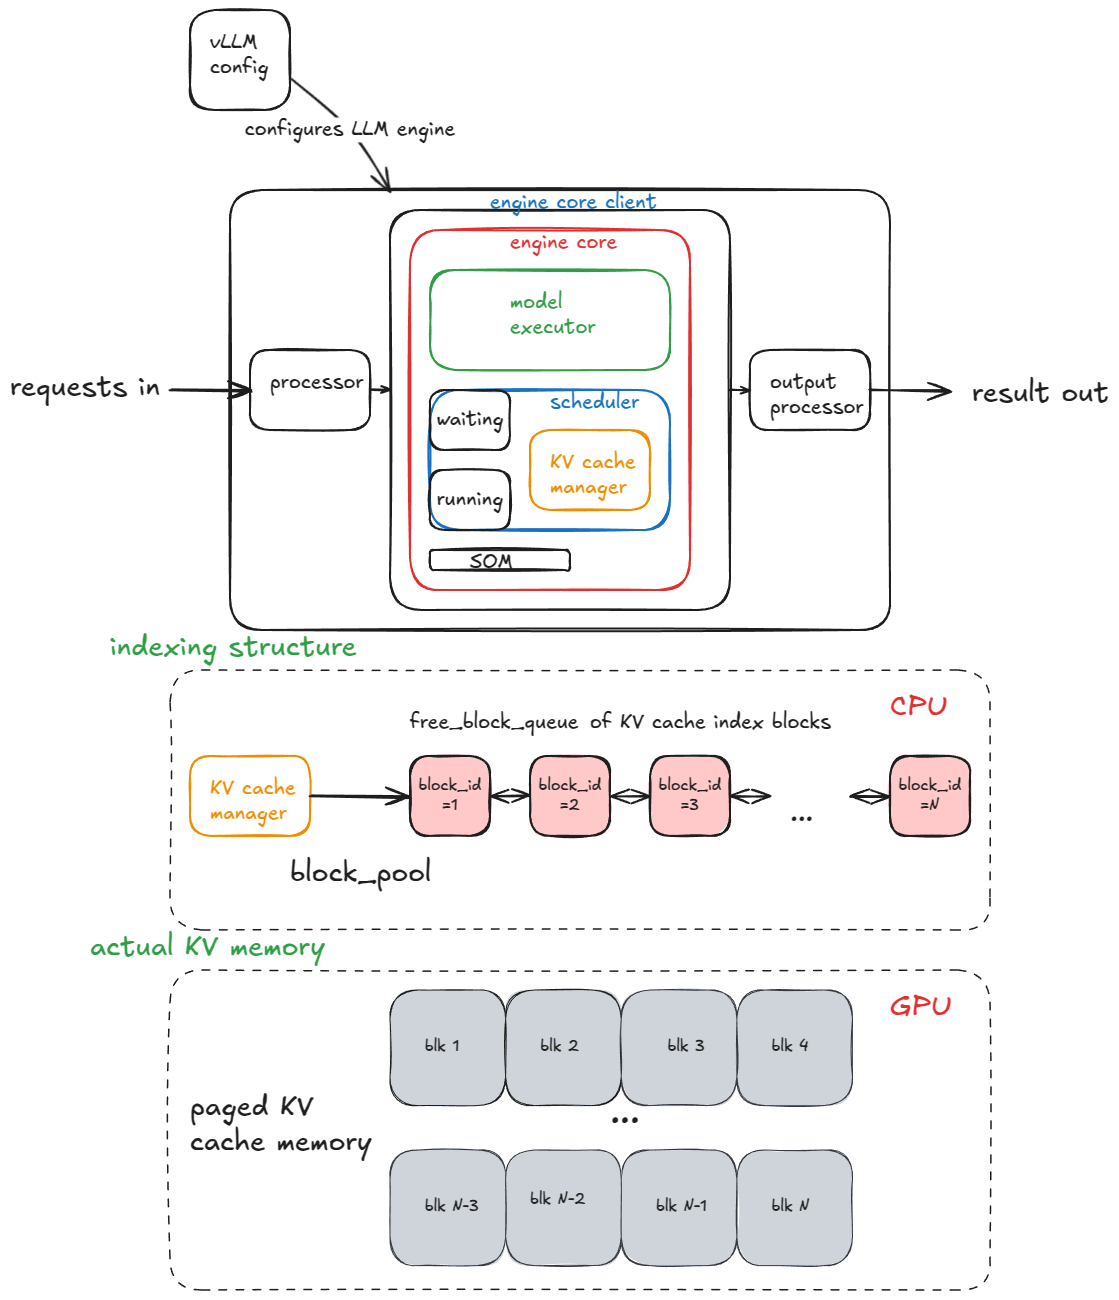
Image · Source originale
L'article décortique le fonctionnement interne de vLLM, moteur d'inférence largement utilisé pour déployer des LLM en production. Il couvre les mécanismes clés comme le PagedAttention, la gestion de mémoire et l'ordonnancement des requêtes qui permettent d'atteindre un haut débit.
Traduit et résumé par IA à partir de l'article d'aleksagordic.com ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- PSSA : un modèle de langage non-transformer écrit from scratch en Rust30 septembre 2026
- Comment transformer GLM-5.3-Flash en modèle de décision rapide façon Jev26 septembre 2026
- Pourquoi le speculative decoding est-il rapide ?19 octobre 2026
- Modèles de langage récursifs chaînés pour raisonnement multi-itérations5 août 2026
- DeepSeek-V4.1 Flash : repousser les limites de la compression du KV cache17 septembre 2026
- Modèles denses vs MoE : paramètres actifs, débit et critères de choixNVIDIA · 15 septembre 2026