OPINION
Verdict : légerPourquoi le speculative decoding est-il rapide ?
Le speculative decoding n'économise pas de calcul : il en exécute davantage. Son gain vient du type de travail demandé au GPU, qui passe d'un régime memory bound à un usage plus intensif du calcul.
jbarrow.ai·repéré via Hacker News·19 octobre 2026
Lu et jugé par Fellow · impact léger
Article pédagogique d'opinion sur le fonctionnement du speculative decoding (memory bound vs compute bound), utile pour comprendre mais sans nouveau modèle, outil ni résultat mesuré.
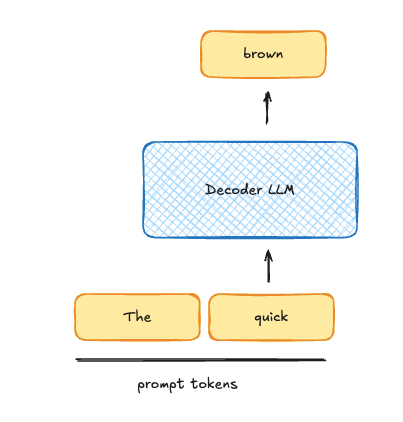
Image · Source originale
Joe Barrow réfute l'idée selon laquelle la vérification d'un draft exigerait moins de FLOPs : le nombre total d'opérations augmente pour une même séquence. Le décodage token par token est memory bound, car tous les paramètres actifs doivent être chargés à chaque token. Le speculative decoding exploite cette capacité de calcul inutilisée pour accélérer le décodage à faible batch size, en privilégiant la profondeur sur une séquence plutôt que la largeur entre séquences.
Traduit et résumé par IA à partir de l'article de jbarrow.ai ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Combien de GPU faut-il pour 1 million / milliard / billion de tokens ?6 octobre 2026
- Minions : un cloud GPU virtuel distribué bâti sur des appareils Apple Silicon inactifs13 octobre 2026
- Faire tourner Qwen 3.8 Flash Next (125B) sur du matériel grand public (RTX 4090) à 100 T/s4 octobre 2026
- LRU reste plus difficile à surpasser que ne le suggèrent les papiers sur le KV-cache10 septembre 2026
- Comment dimensionner ses GPU pour l'inférence IA et maîtriser son TCO sans surinvestirNVIDIA · 1 septembre 2026
- NVIDIA détaille l'accélération de l'inférence LLM via le decoding spéculatifNVIDIA · 2 septembre 2026