Test du modèle Kimi K3 dans Claude Code
Titre à nuancer : Le titre affirme une supériorité alors que l'auteur conclut que K3 ne remplace pas Claude et reste moins fiable.
L'ingénierie prompt et le modèle Kimi K3 dépassent les capacités natives de Claude Code.
Lu et jugé par Fellow · impact notable
Test pratique sur tâche de code montrant K3 compétitif et moins cher, mais auteur juge Claude plus fiable.
Traduit et résumé par IA à partir de l'article de philippdubach.com ↗ · Comment Fellow travaille
Développement
· Généré par GLM 4.7↓ LIRE LE DÉVELOPPEMENT · 2 MIN← MASQUER LE DÉVELOPPEMENT
Moonshot AI a récemment dévoilé Kimi K3, un modèle de mélange d'experts (MoE) de 2,8 billions de paramètres, conçu pour concurrencer directement les modèles fermés les plus performants du marché. L'intérêt de cette architecture réside dans sa capacité à n'activer qu'une fraction des paramètres pour chaque token, optimisant ainsi l'efficacité tout en gérant un contexte immense, allant jusqu'à un million de tokens. La particularité majeure de cette sortie réside dans la promesse de Moonshot de publier les "open weights" du modèle. Cette approche, distincte de l'open source complet, permet aux développeurs de télécharger et d'exécuter les poids du modèle, même si le code et les données d'entraînement ne sont pas fournis. Toutefois, au moment du test, ces poids n'étaient pas encore disponibles, la date de publication étant fixée au 27 juillet 2026.
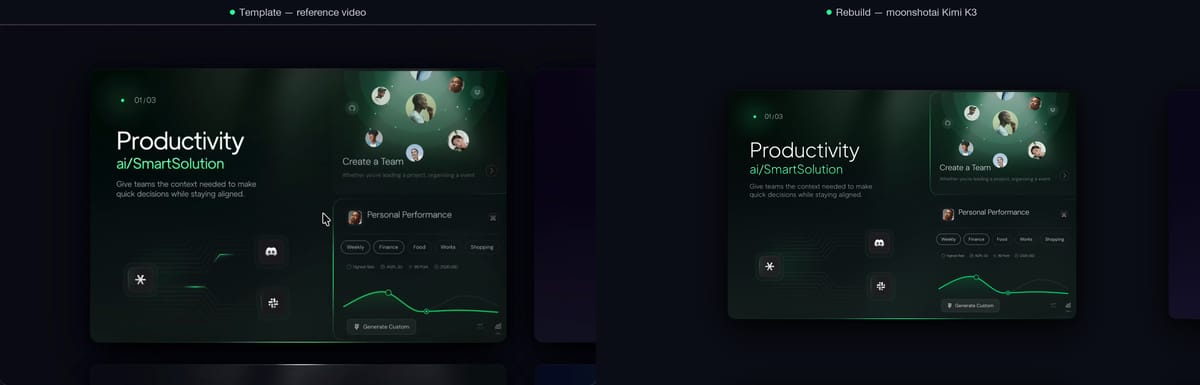
L'expérience menée consistait à intégrer Kimi K3 dans l'environnement Claude Code, un agent d'orchestration qui relie un modèle de langage à des fichiers et des outils de développement, afin de remplacer le modèle natif par cette nouvelle alternative via OpenRouter. Si les premiers échanges ont semblé plus lents que ceux du modèle habituel, probablement en raison de l'acheminement via un routeur tiers, cette latence s'est estompée une fois l'outil pris en main. Le test s'est focalisé sur une tâche de reconstruction d'interface frontend, un domaine où Kimi K3 s'était illustré en tête du classement Code Arena. En utilisant des actifs et un prompt détaillés provenant d'un projet existant, le modèle a démontré une grande fidélité dans la restitution du design et de la structure, validant ses capacités en ingénierie prompt et en génération visuelle.
L'analyse des coûts révèle un avantage économique significatif pour l'utilisation de K3 dans ce workflow. Sur un volume de 115 requêtes, l'utilisation massive du cache de prompt — près de 95 % des tokens d'entrée — a permis de contenir la facture totale à 7,18 dollars. Une estimation basée sur les tarifs publiés par Anthropic pour un volume de trafic équivalent situe le coût de Claude Opus 4.8 à environ 11,96 dollars, et celui de Fable 5 à près de 23,92 dollars. Kimi K3 s'avère ainsi environ 40 % moins cher que Opus et 70 % moins cher que Fable dans cette configuration spécifique. Ce différentiel de prix, couplé à des performances jugées satisfaisantes pour de nombreuses tâches, positionne le modèle comme une alternative crédible pour les utilisateurs sensibles aux coûts d'infrastructure.
Malgré ces résultats prometteurs, l'auteur nuance la portée de l'expérience. Kimi K3 ne remplace pas totalement les modèles de pointe comme Claude Opus ou Fable 5 pour les tâches complexes nécessitant une grande fiabilité et une gestion fine de l'ambiguïté. Le modèle a montré certaines limites, notamment une tendance à la proactivité excessive et une sensibilité au contexte logiciel environnant, des défauts reconnus par Moonshot AI elle-même. L'article soulève également des questions sur la durabilité de l'avantage des modèles fermés. La disponibilité de poids ouverts de haute qualité pourrait exercer une pression à la baisse sur les prix des API et rendre la distinction entre les modèles moins pertinente, déplaçant la valeur vers les outils d'intégration, les workflows et les données propriétaires. L'arrivée de modèles compétitifs comme K3 suggère une commoditisation rapide de la couche modèle, remettant en cause les stratégies d'investissement massif des grands laboratoires américains qui misent sur la rareté de l'intelligence de pointe.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Show HN : agent-usage-guard, un mod Claude Code pour protéger votre fenêtre d'usage22 octobre 2026
- Comment un évaluateur pourrait examiner le contrôle et la surveillance des agents IA internes14 octobre 2026
- FDE-Gym : le dernier kilomètre de la livraison de l'IA15 octobre 2026
- Fuse : raisonnement social vérifiable pour assistants LLM15 septembre 2026
- Adaptation à l'usage : quand l'interaction humain-IA affine les agents en temps réel3 septembre 2026
- HarnessTax : quel est le poids du harnais sur les performances des agents de code ?17 septembre 2026