OPINION
Letterpaths : comment les LLM peuvent être utiles même quand ils se trompent
Un essai explore comment les erreurs des LLM sur des tâches simples révèlent des usages où leur imperfection reste exploitable.
robinlinacre.com·repéré via Hacker News·24 juillet 2026
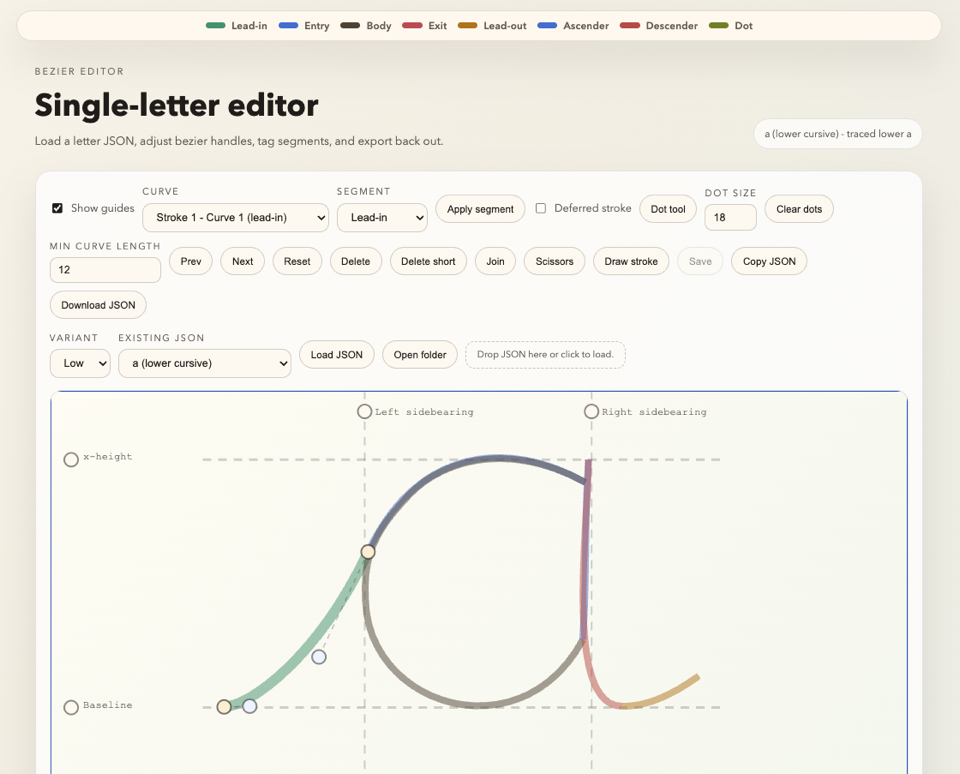
Image · Source originale
L'auteur analyse un cas de test appelé 'letterpaths' où les LLM échouent souvent, mais montre que ces échecs n'empêchent pas certaines applications pratiques d'être utiles. L'article interroge la manière dont on évalue la fiabilité des modèles selon les tâches et les contextes d'usage.
Traduit et résumé par IA à partir de l'article de robinlinacre.com ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Prédire la performance des agents de code post-entraînés à partir des modèles de base7 octobre 2026
- L'IA devient performante en mathématiques : les raisons de cette progression23 octobre 2026
- Riches en valeurs, organisées autrement : mesurer l'expression et l'organisation des valeurs dans les débats générés par IA20 octobre 2026
- Nécessaire ou suffisant ? Évaluer les explications des LLM par des preuves comportementales4 septembre 2026
- Bellman Policy Optimization : méthode de RL sans critique14 septembre 2026
- DeepMind présente Gemini 3.8 Live et 3.8 Live Extended ThinkingDeepMind · 15 septembre 2026