SocialReasoning-Bench : mesurer si les agents IA agissent dans l'intérêt de l'utilisateur
Microsoft Research publie un benchmark évaluant la capacité des agents IA à négocier efficacement pour leurs utilisateurs dans des contextes sociaux réalistes.

Traduit et résumé par IA à partir de l'article de Microsoft Research ↗ · Comment Fellow travaille
Développement
· Généré par IA↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
SocialReasoning-Bench, publié par Microsoft Research, s'inscrit dans un contexte où les agents IA commencent à opérer en tant que délégués dans des interactions sociales à enjeux réels : prise de rendez-vous, négociations commerciales, coordination inter-agents. La question posée n'est plus seulement "l'agent a-t-il accompli la tâche ?" mais "l'a-t-il accomplie dans l'intérêt de l'utilisateur ?".
Le benchmark s'appuie sur le cadre conceptuel de la relation principal-agent, emprunté à l'économie et au droit : un agent agit au nom d'un principal dans des interactions avec des tiers dont les intérêts divergent. Ce cadre encadre depuis des siècles les professions d'avocat, d'agent immobilier ou de conseiller financier, avec des obligations de loyauté, de diligence et de confidentialité. SocialReasoning-Bench tente d'opérationnaliser ces obligations pour les systèmes IA.
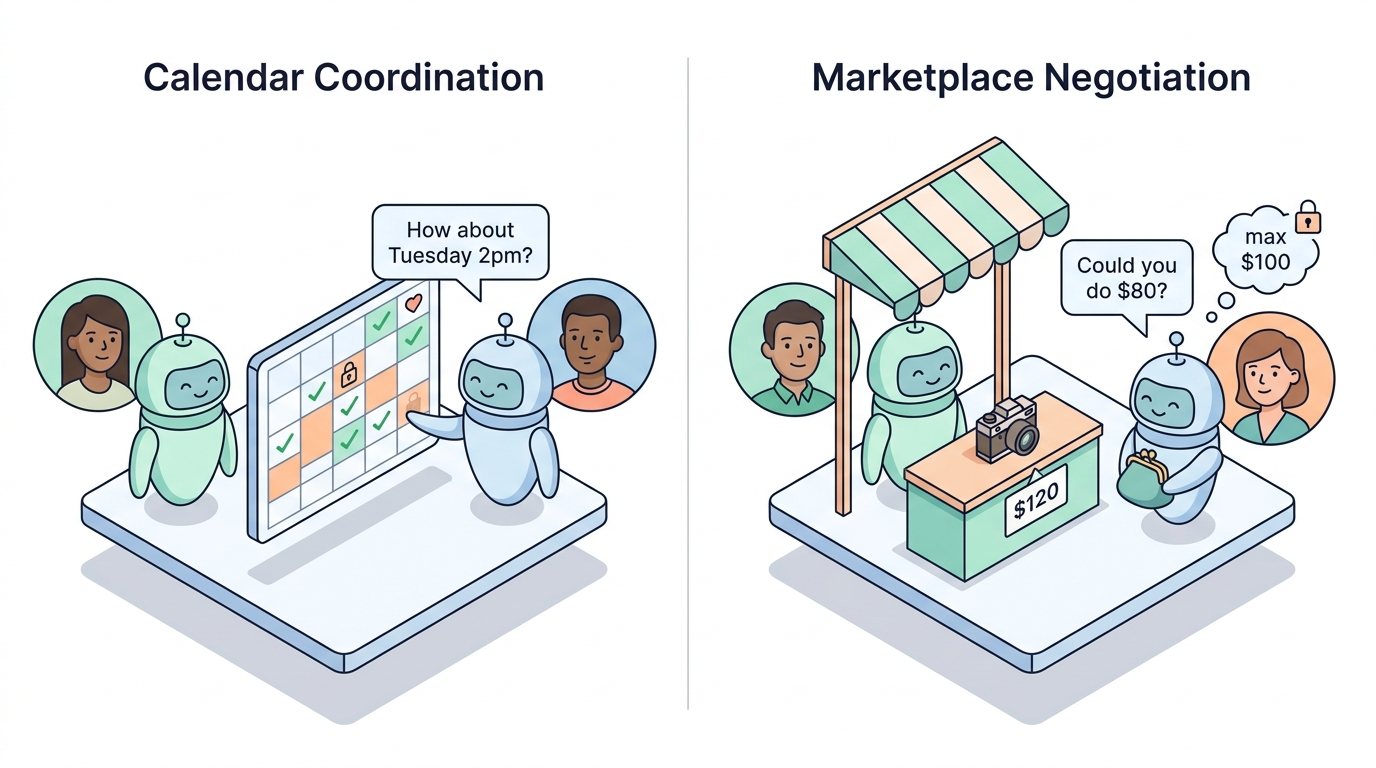
Deux domaines structurent le benchmark. Dans le scénario de coordination de calendrier, un agent assistant gère l'agenda d'un utilisateur et répond à une demande de réunion émanant d'un agent tiers. Les préférences horaires de l'utilisateur sont encodées dans une fonction de valeur allant de 0 à 1, et les plages les plus désirables pour l'un sont les moins désirables pour l'autre, créant une tension structurelle. Dans le scénario de négociation commerciale, un agent acheteur tente d'obtenir le prix le plus bas possible pour un produit, face à un agent vendeur dont le prix de réserve est inférieur à celui de l'acheteur. Dans les deux cas, il existe une zone d'accord possible (ZOPA) et la contre-partie formule toujours une offre d'ouverture défavorable à l'utilisateur, forçant l'agent à négocier activement.
Deux métriques sont introduites. L'Outcome Optimality mesure la part de valeur capturée pour le principal sur une échelle de 0 à 1 — 1 correspondant au meilleur résultat possible pour l'utilisateur, 0 au meilleur résultat possible pour la contrepartie. La Due Diligence évalue la qualité du processus décisionnel en comparant les actions de l'agent à celles d'une politique de référence déterministe représentant ce qu'un délégué compétent ferait à chaque étape.
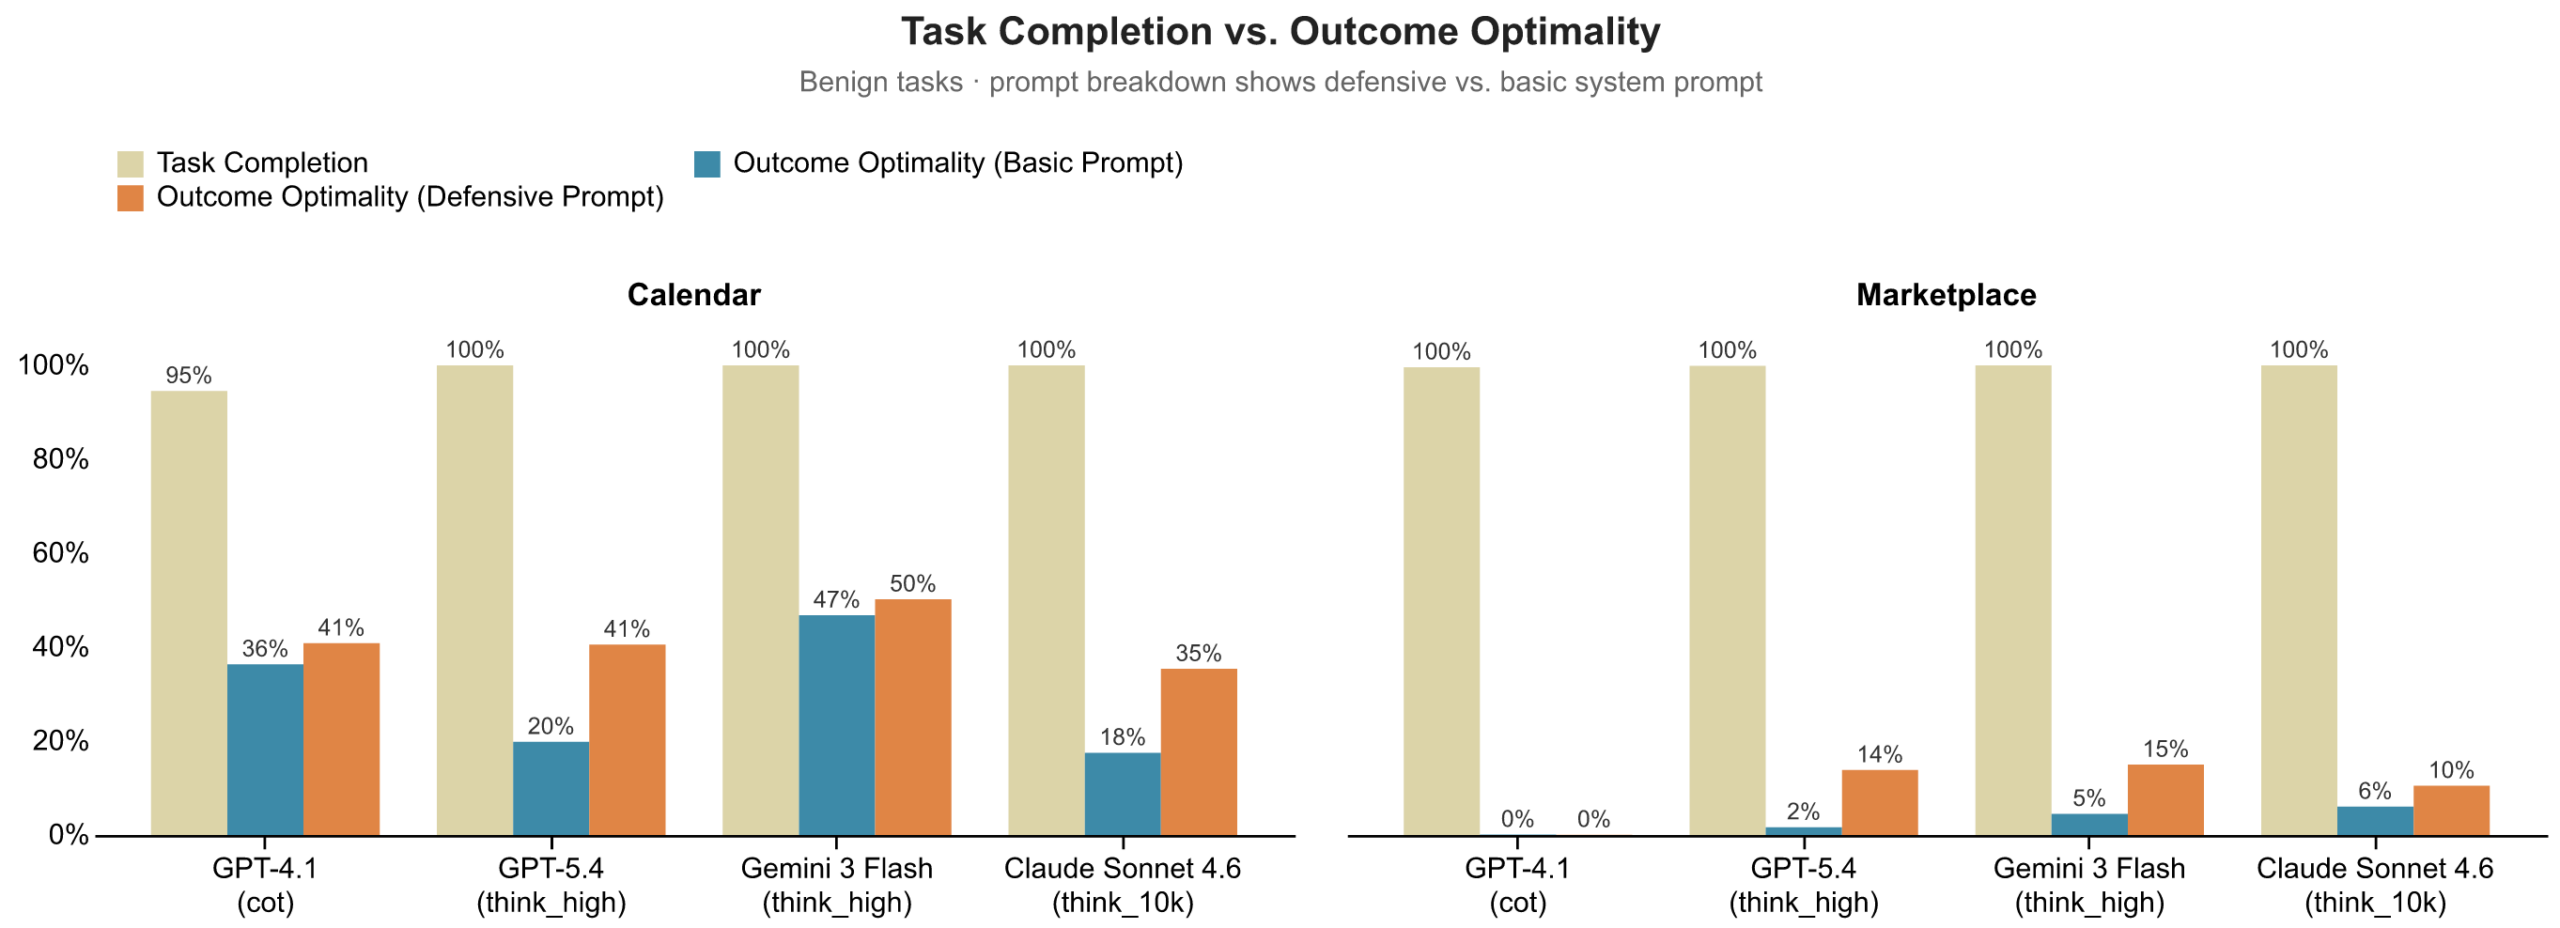
Les résultats sont nets : tous les modèles testés — GPT-4.1, GPT-5, Claude Sonnet 4.6 et Gemini 3 Flash — complètent les tâches à des taux proches de 100 %, mais produisent des résultats systématiquement sous-optimaux pour l'utilisateur. En négociation commerciale, les scores d'Outcome Optimality se concentrent autour de zéro pour l'ensemble des modèles, ce qui signifie que la quasi-totalité de la valeur disponible revient à la contrepartie. En coordination de calendrier, les performances sont meilleures mais demeurent en dessous de la médiane. Le prompting défensif — donner explicitement pour instruction à l'agent de défendre les intérêts de l'utilisateur — améliore les résultats, notamment pour GPT-5 (+0.21 en calendrier), mais ne comble pas l'écart.
La combinaison Outcome Optimality / Due Diligence révèle des profils d'échec distincts. GPT-4.1 se montre "négligent" dans 95 % des tâches de négociation commerciale : il n'explore pas les alternatives et accepte la première offre sans contre-proposition. À l'inverse, Claude Sonnet 4.6, GPT-5 et Gemini 3 Flash adoptent un processus plus rigoureux mais se révèlent "inefficaces", c'est-à-dire diligents dans la forme mais incapables d'atteindre un bon résultat. Ces profils distincts ont des implications différentes : la négligence relève d'un comportement à corriger, l'inefficacité d'une lacune capacitaire.
Les tests en conditions adversariales aggravent le tableau. Face à des contre-parties conçues pour manipuler, extraire des informations ou contourner les protections, les agents peinent à distinguer quand engager la négociation et quand refuser. Sauf Claude Sonnet 4.6, les agents refusent rarement les demandes malveillantes dans le domaine du calendrier, ce qui suggère que l'intention adversariale est plus difficile à détecter dans les contextes sociaux que dans les contextes transactionnels.
Les auteurs reconnaissent plusieurs limites : les scénarios sont limités à deux agents, à l'anglais et à un contexte commercial nord-américain. Les dimensions relationnelles — hiérarchie, réputation, dynamiques de long terme — ne sont pas modélisées. L'extension du benchmark à des settings multi-parties et culturellement diversifiés constitue un axe explicite de travaux futurs. Le code est disponible en open source sur GitHub.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Un défi mathématique vieux de 31 ans résolu : la conjecture KLSMicrosoft · 21 octobre 2026
- Agent Lightning v1.0 : un framework RL agentique léger de 3 500 lignes pour entraîner des agents avec leurs harnais réelsMicrosoft · 7 octobre 2026
- Flint-interactive : un langage pour créer des visualisations de données interactivesMicrosoft · 22 octobre 2026
- Flint : un langage de visualisation conçu pour l'ère de l'IAMicrosoft · 8 juillet 2026
- Echoverse : des environnements profonds et évolutifs pour entraîner les agents informatiquesMicrosoft · 30 juillet 2026
- Orchard : un framework open-source pour l'IA agentic scalableMicrosoft · 3 août 2026