La fin du fine-tuning ? OpenAI déprécie ses APIs et relance le débat
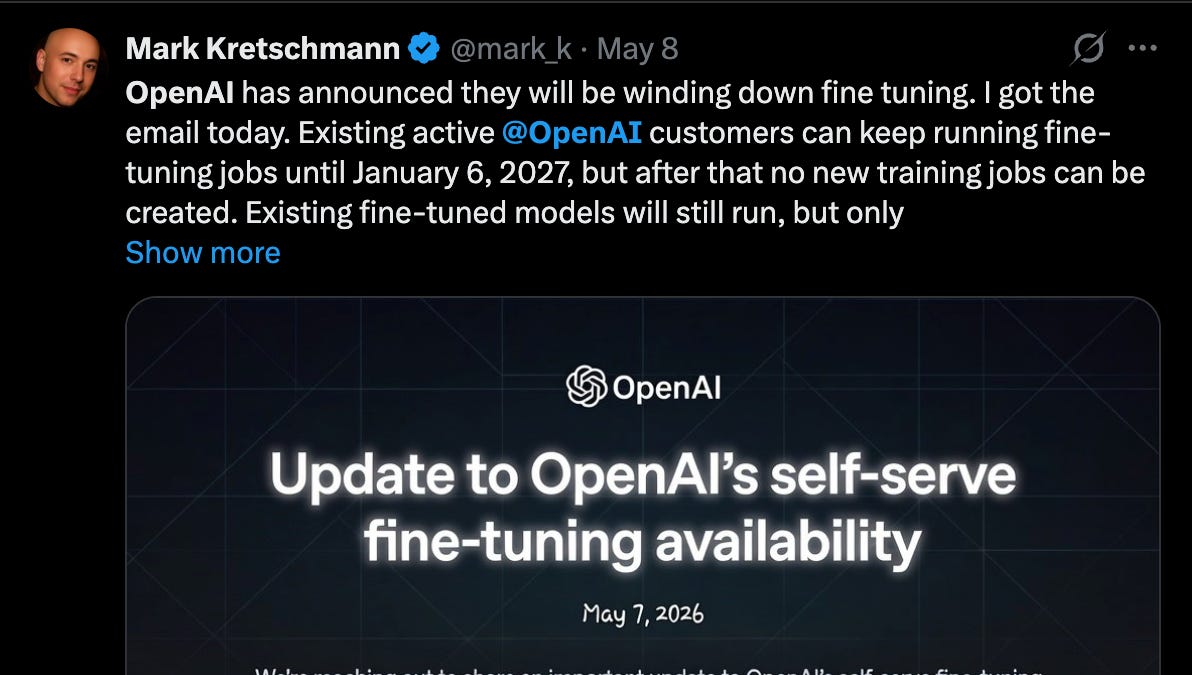
La dépréciation des APIs de fine-tuning d'OpenAI ravive une question centrale : le fine-tuning est-il en train de disparaître du toolkit des ingénieurs IA ?
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Développement
· Généré par IA↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
La dépréciation des APIs de fine-tuning par OpenAI marque une rupture symbolique. Pendant plusieurs années, la capacité à affiner ses propres modèles via l'API d'OpenAI constituait un argument commercial distinctif, souvent présenté sous la formule "performances de o1 au prix de 4o". Cette promesse animait une partie importante des discours d'ingénieurs IA et justifiait des architectures applicatives entières construites autour du fine-tuning supervisé. La décision de déprécier ces endpoints ferme formellement cette parenthèse.
Le contexte immédiat est une pression GPU généralisée. OpenAI fait face à une contrainte de compute qui touche simultanément d'autres projets : Sora avait déjà été mis en retrait plus tôt dans l'année. Dans un environnement où chaque heure de GPU est arbitrée, maintenir une infrastructure de fine-tuning à la demande pour des milliers de clients tiers représente un coût d'opportunité élevé. La décision s'inscrit donc dans une logique de priorisation, pas nécessairement dans un rejet technique du fine-tuning comme méthode.
Mais la tendance de fond existait indépendamment de cette contrainte. Dès octobre 2023, Jeremy Howard de Fast.ai alertait sur ce mouvement lors d'un épisode du podcast Latent Space : le fine-tuning supervisé via API tiers était déjà en déclin pour la majorité des cas d'usage courants. L'essor des fenêtres de contexte longues — jusqu'à plusieurs centaines de milliers de tokens chez certains modèles — a rendu le prompting extensif viable là où le fine-tuning semblait indispensable. La constitution de Claude, document de plusieurs milliers de mots intégré directement en contexte, illustre cette logique portée à son extrême : la personnalisation par prompt plutôt que par modification des poids.
La nuance essentielle tient dans la distinction entre les deux tiers inférieurs et le premier centile des applications IA. Pour la majorité des équipes produit, des RAG bien construits et des prompts longs suffisent à couvrir 80 % des besoins. Mais les acteurs les plus avancés — Cursor et Cognition sont cités explicitement — ont au contraire augmenté leur usage du RLFT (reinforcement learning from human feedback avec fine-tuning) sur des modèles open-weights. Cognition, dont la levée de fonds à 25 milliards de dollars venait de devenir publique au moment de la publication, construirait une partie de son avantage compétitif sur des modèles ouverts fine-tunés en interne, loin des APIs grand public.
Cette bifurcation structure le débat : le fine-tuning ne disparaît pas, il se déplace. Il sort des APIs managées pour entrer dans les infrastructures propriétaires des équipes disposant des ressources nécessaires. Les modèles open-weights comme ceux de la famille Qwen ou les modèles Meta deviennent le terrain de jeu privilégié pour le RLFT avancé, tandis que les offres cloud standardisées perdent leur pertinence pour ce cas d'usage. La thèse des ASICs custom, évoquée dans l'article, suggère que le fine-tuning sur modèles ouverts pourrait également devenir central dans des stratégies d'optimisation matérielle, où l'adaptation fine d'un modèle à une architecture de puce spécifique justifie le coût.
La question ouverte est celle du seuil de complexité applicative à partir duquel le fine-tuning redevient nécessaire. Les benchmarks récents sur des tâches de raisonnement avancé — mathématiques de niveau recherche, physique théorique, coding de longue durée — montrent que les systèmes agentiques combinant fine-tuning et décomposition en agents spécialisés surpassent les approches prompt-only sur les tâches les plus dures. Physics-intern booste Gemini de 17,7 % à 31,4 % sur CritPt par décomposition en agents spécialisés, sans que le fine-tuning soit nécessairement exclu de la chaîne.
Pour les équipes qui ne disposent pas de l'infrastructure de Cursor ou Cognition, la dépréciation d'OpenAI est une invitation à réévaluer leur stack. Les alternatives concrètes sont les modèles open-weights avec fine-tuning autohébergé, les prompts longs avec des modèles à grande fenêtre de contexte, ou les approches hybrides RAG plus instruction détaillée. Le fine-tuning via API managée, lui, entre dans sa phase terminale — du moins chez OpenAI.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Spécialiser le vocabulaire des SLM peut réduire de 77 % le coût d'inférence dans des applications réellesHugging Face · 21 octobre 2026
- Clef : des modèles de décision en open-weight et une nouvelle plateforme de fine-tuning par RL1 octobre 2026
- Fine-tuning d'un modèle de 235 milliards de paramètres sur 4 GPU, puis constat qu'il n'était plus nécessaire19 octobre 2026
- Avenir de llama.cpp après l'acquisition d'HuggingFace par Nvidia4 septembre 2026
- Xiaomi AI Cube et Xring O100 : 1,22 To/s, 330 tokens/s pour un LLM local de 120B24 août 2026
- Para-Pipe : parallélisme hiérarchique sur SoC3 septembre 2026