Hot Chips : OpenAI Jalapeño, Cerebras CS-5, Groq 3 LPX, Apple M6
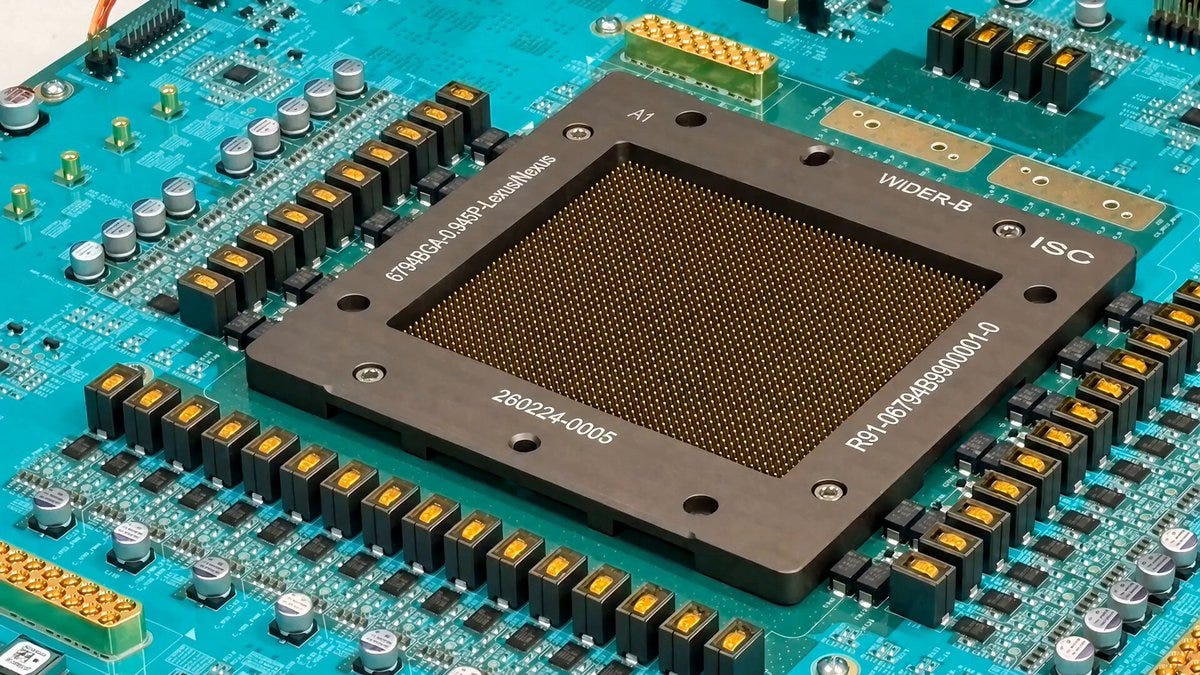
OpenAI dévoile son puce inference Jalapeño, surpassant NVIDIA en efficacité énergétique lors de la conférence Hot Chips.
Lu et jugé par Fellow · impact majeur
OpenAI a livré des benchmarks précis (1.5–1.9× par watt, latence -3.6×) et une date de déploiement fin 2026.
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Développement
· Généré par GLM 4.7↓ LIRE LE DÉVELOPPEMENT · 2 MIN← MASQUER LE DÉVELOPPEMENT
La présentation de la puce d’inférence Jalapeño par OpenAI lors de la conférence Hot Chips marque une accélération significative dans la stratégie matérielles des laboratoires d’intelligence artificielle. Moins d’un an après l’annonce de son partenariat avec Broadcom, l’entreprise fournit des benchmarks chiffrés positionnant cette puce comme une alternative directe aux systèmes NVIDIA GB200 et GB300. L’architecture de Jalapeño affiche une efficacité énergétique supérieure, avec un gain de travail effectué par watt compris entre 1,5 et 1,9 fois par rapport aux solutions actuelles du leader du marché lors de tests à débit maximal. La latence de bout en bout est réduite d’un facteur 1,7 à 3,6, et les workloads interactifs voient leurs performances multipliées par 2,1 à 4,1. Contrairement aux GPU classiques souvent sollicités à leur limite thermique, la puce d’OpenAI, bien que notée à 700W, est restée à 550W ou moins durant les essais, suggérant une marge de manœuvre opérationnelle et une meilleure stabilité thermique.
Au-delà des chiffres bruts, la performance de Jalapeño tient à une approche de conception qui vise à réduire les compromis habituels entre débit et latence. Plusieurs analyses techniques notent que ces résultats ont été obtenus sans l’utilisation de techniques d’optimisation agressives courantes sur les systèmes NVIDIA, telles que la désagrégation poussée entre les phases de prefill et de décodage ou le speculative decoding. Le fait qu’une première génération de puce surpasse des systèmes concurrents utilisant ces raffinements logiciels indique une optimisation matérielle profonde de la chaîne d’inférence. OpenAI prévoit un déploiement interne de cette puce d’ici la fin de l’année, tandis que les générations suivantes sont déjà en cours de développement, confirmant l’ampleur de l’investissement sur le long terme.
Un aspect particulièrement novateur révélé par l’équipe d’ingénierie concerne le rôle des modèles dans la conception même de la puce. OpenAI indique avoir utilisé GPT-Astra et Codex pour écrire et optimiser les noyaux de bas niveau (kernels) destinés à faire tourner les modèles sur Jalapeño. Cette assistance automatisée aurait permis d’amener trois modèles open-weight initialement non prévus pour cette architecture à des niveaux de performance élevés en seulement deux mois. Pour des blocs spécifiques d’attention et de MoE (Mixture of Experts), le code généré par l’IA s’est exécuté 1,5 à 1,8 fois plus vite que des implémentations écrites par des experts humains. Ce phénomène illustre un changement de paradigme où l’amélioration des compilers et des micro-logiciels s’intègre directement à la boucle d’amélioration des modèles, rendant la co-conception logicielle-matérielle plus dépendante de l’automatisation.
Cette annonce s’inscrit dans un mouvement plus large de verticalisation de l’infrastructure par les acteurs du frontier AI, illustré également par les autres déclarations faites à Hot Chips. Si Jalapeño prouve que les laboratoires peuvent reprendre le contrôle de leur économie d’inférence, la production reste soumise aux contraintes de la fonderie et des capacités de packaging comme CoWoS. Parallèlement, des avancées sont constatées dans l’optimisation de l’exécution des agents, avec des travaux comme AutoSaddler de Microsoft qui traitent le « harness » (l’environnement d’exécution de l’agent) comme du code patchable, permettant des gains significatifs sur des benchmarks comme GAIA2 et SWE-Bench Pro. Ces évolutions suggèrent que les performances futures des systèmes d’IA dépendront autant de l’efficacité des puces comme Jalapeño que de la sophistication des couches logicielles d’orchestration et de mémoire qui les entourent.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Exécuter des modèles d'IA de classe frontier sur 8 nœuds NVIDIA DGX SparkNVIDIA · 22 octobre 2026
- L'IA capable de concevoir son propre matériel d'inférence : le projet openTPU6 octobre 2026
- Optimisation poussée de Kimi K3 dans vLLM sur NVIDIA GB30018 octobre 2026
- NVIDIA détaille comment l'exécution déterministe Groq 3 LPX optimise l'inférence sur Vera RubinNVIDIA · 15 septembre 2026
- Xiaomi AI Cube et Xring O100 : 1,22 To/s, 330 tokens/s pour un LLM local de 120B24 août 2026
- NVIDIA Groq 3 LPX : ultra-rapidité et long contexte sur Vera RubinNVIDIA · 24 août 2026