OUTILS
Verdict : notableOptimisation poussée de Kimi K3 dans vLLM sur NVIDIA GB300
L'équipe vLLM a bâti, avec l'aide d'agents de code, un chemin de décodage CuTe DSL pour Kimi K3 sur GB300 : plus de 840 tokens/s à batch 1 sur 16 GPU, et un nouveau cadre de revue.
vllm.ai·repéré via Hacker News·18 octobre 2026
Lu et jugé par Fellow · impact notable
Optimisation vLLM réelle pour Kimi K3 sur GB300 (840 tokens/s à batch 1, 1,5 à 2× de débit) avec PR et RFC publiés, mais limitée à un matériel précis et à des chiffres auto-rapportés.
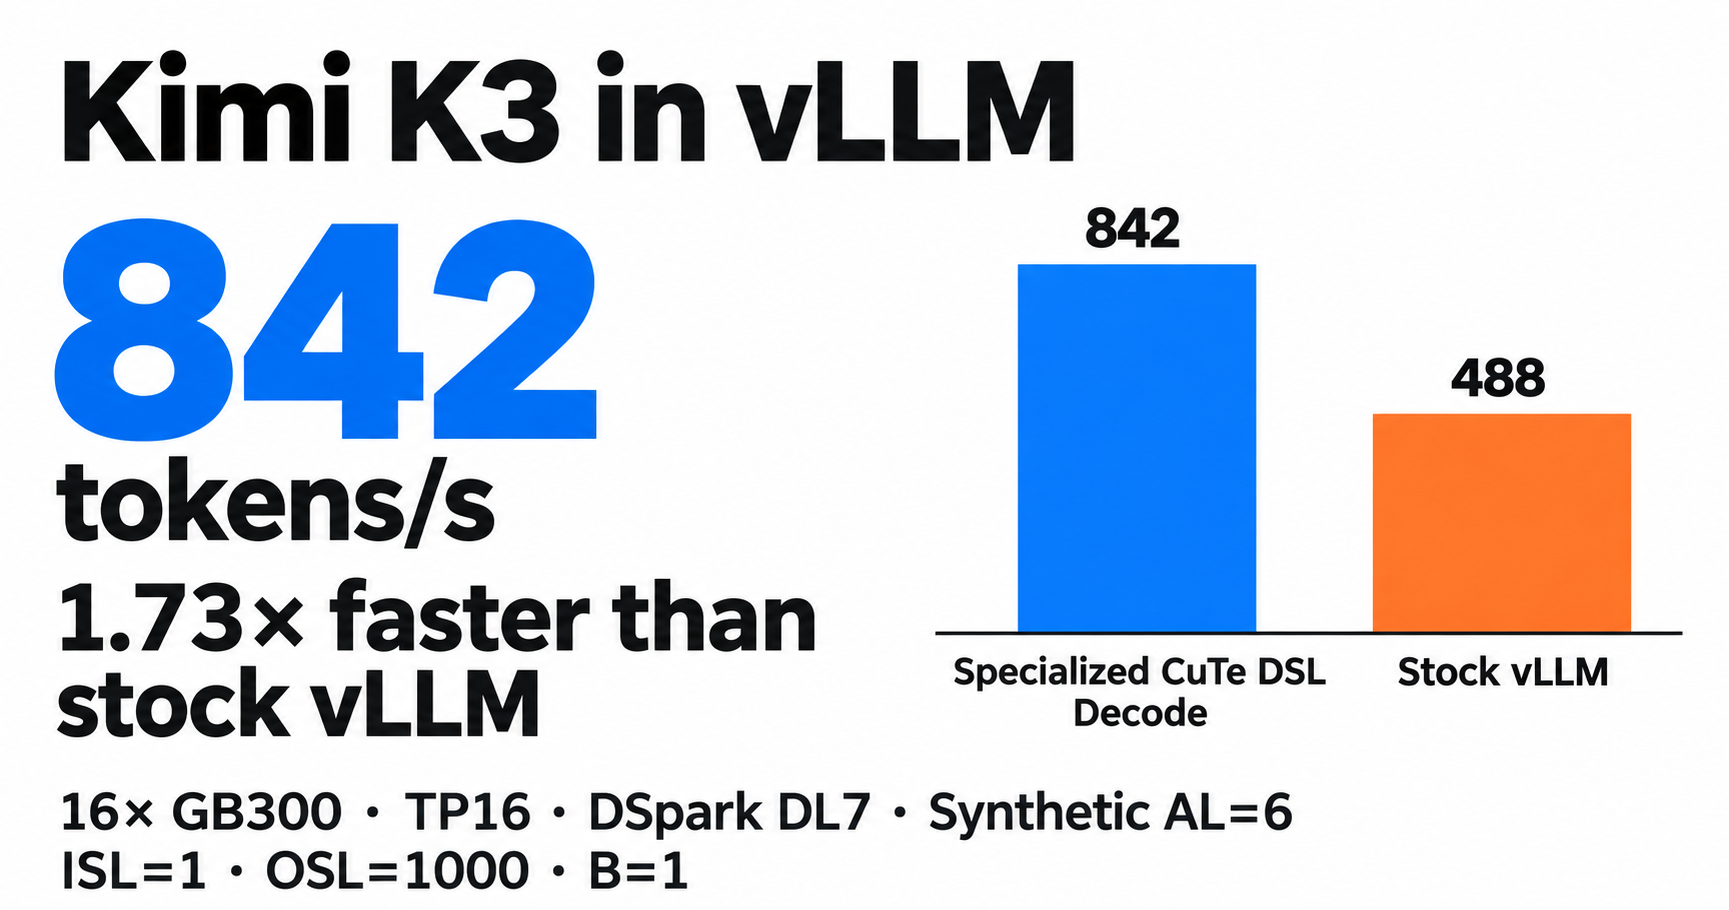
Image · Source originale
vLLM décrit un chemin de décodage unifié en CuTe DSL pour Kimi K3 sur NVIDIA GB300 (8 ou 16 GPU), couvrant attention, MoE et communication. Les résultats annoncés : plus de 840 tokens/s à batch 1 sur 16 GPU avec DSpark (AL=6 synthétique), un débit de décodage 1,5 à 2× supérieur dans plusieurs configurations et jusqu'à 1,8× d'interactivité P90 sur AgentX. Le billet propose aussi un modèle d'optimisation accéléré (RFC) fondé sur l'isolation des changements et la validation systématique.
Traduit et résumé par IA à partir de l'article de vllm.ai ↗ · Comment Fellow travaille
À lire aussi
- DeepSeek-V4.1-Flash : repousser les limites de la compression du cache KVDeepSeek · 1 octobre 2026
- Launch HN : Magnitude (YC S25), un moteur d'inférence auto-optimisant pour agents30 septembre 2026
- Nesbox : une MicroVM rapide avec partage de GPU24 septembre 2026
- TokTier : tokenisation avec état exacte pour serveurs d'agents LLM31 juillet 2026
- Optimisations NIM : x2.5 utilisateurs sur Nemotron 3 UltraNVIDIA · 10 septembre 2026
- CoBa : un routage à budget de calcul équilibré pour un test-time scaling plus économique7 août 2026