OUTILS
AMD et Cerebras lancent une solution d'inférence IA
Un partenariat pour une inférence ultra-rapide à haut débit.
cerebras.ai·repéré via Hacker News·24 juillet 2026
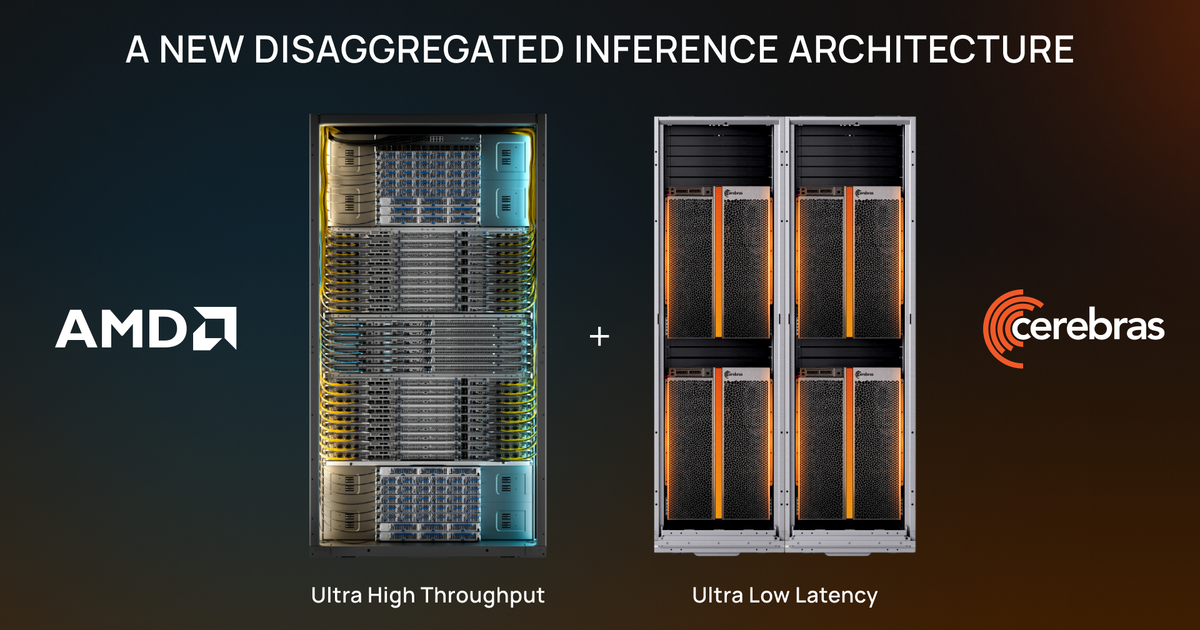
Image · Source originale
AMD et Cerebras annoncent une solution d'inférence combinant les processeurs AMD Instinct MI300X à l'architecture WSE de Cerebras. Cette offre vise à réduire drastiquement la latence et à maximiser le débit pour les modèles LLM.
Traduit et résumé par IA à partir de l'article de cerebras.ai ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Exécuter des modèles d'IA de classe frontier sur 8 nœuds NVIDIA DGX SparkNVIDIA · 22 octobre 2026
- Multi-Token Prediction adaptative : jusqu'où aller dans l'horizon de spéculation ?20 octobre 2026
- Pourquoi le speculative decoding est-il rapide ?19 octobre 2026
- NVIDIA détaille comment l'exécution déterministe Groq 3 LPX optimise l'inférence sur Vera RubinNVIDIA · 15 septembre 2026
- H Company optimise la gestion VRAMH Company · 25 juin 2026
- Comment OpenAI a utilisé ses propres LLM pour concevoir sa puce Jalapeño19 septembre 2026