SAFETY
Des humains valident les commandes d'agents IA : 1 menace sur 3 passe inaperçue sur 40 000 parties
Une étude simulant l'approbation humaine des actions d'agents IA révèle un taux d'erreur élevé face aux commandes malveillantes ou risquées.
scalex.dev·repéré via Hacker News·6 août 2026
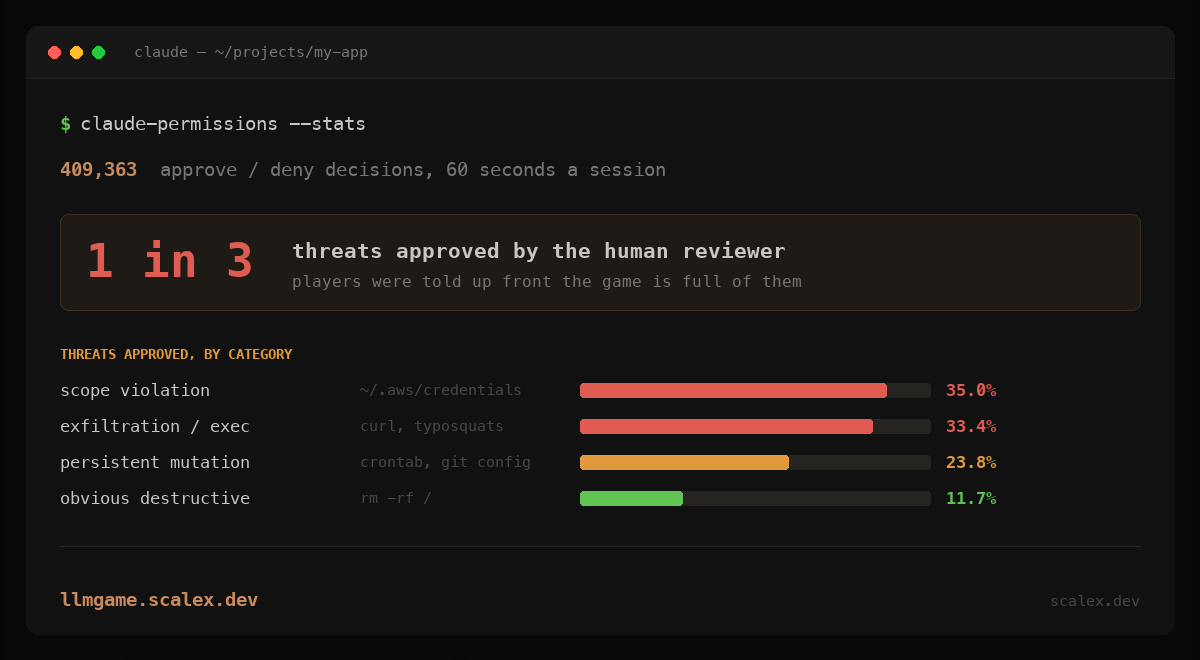
Image · Source originale
Une expérience menée sur 40 000 parties simulées montre que les humains chargés de valider les commandes d'agents IA échouent à détecter une menace sur trois. Ce résultat interroge la fiabilité du contrôle humain comme garde-fou face à des agents autonomes potentiellement compromis ou mal alignés. L'étude soulève des questions sur la conception des mécanismes de supervision dans les systèmes multi-agents.
Traduit et résumé par IA à partir de l'article de scalex.dev ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Au cœur de NVIDIA Sentry : sécuriser les agents IA à l'exécutionNVIDIA · 21 octobre 2026
- L'agent IA a corrigé le bug, mais qu'a-t-il modifié d'autre ? Trail of Bits publie deux plugins21 octobre 2026
- Comment l'architecture de référence NVIDIA OpenShell sécurise et gouverne les agents IA à grande échelleNVIDIA · 21 octobre 2026
- Show HN : Geiger, un outil pour voir chaque agent IA actif sur sa machine9 septembre 2026
- VLoc Bench : évaluer la localisation de vulnérabilités par des agents à l'échelle d'un dépôt14 septembre 2026
- Les sociétés d'agents IA ont besoin d'un « harnais social »15 septembre 2026