Sakana AI lance Fugu, un modèle de langage japonais open-weights
Sakana AI dévoile Fugu, un LLM optimisé pour le japonais et publié en open-weights, renforçant l'écosystème IA nippon.
Traduit et résumé par IA à partir de l'article de sakana.ai ↗ · Comment Fellow travaille
Développement
· Généré par Claude Sonnet 4.6↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
Sakana AI, le laboratoire fondé par d'anciens chercheurs de Google DeepMind dont David Ha, commercialise Fugu, un système présenté non pas comme un modèle de langage unique, mais comme un système multi-agents encapsulé derrière une interface unifiée. L'appellation "open-weights" initialement associée à l'annonce ne correspond pas à ce que révèle la page produit : Fugu est un service API commercial, avec une tarification par abonnement ou à la consommation, et dont les mécanismes internes d'orchestration sont explicitement qualifiés de propriétaires. Le positionnement réel est celui d'un méta-modèle capable de coordonner dynamiquement un pool de LLM tiers pour traiter des tâches complexes.
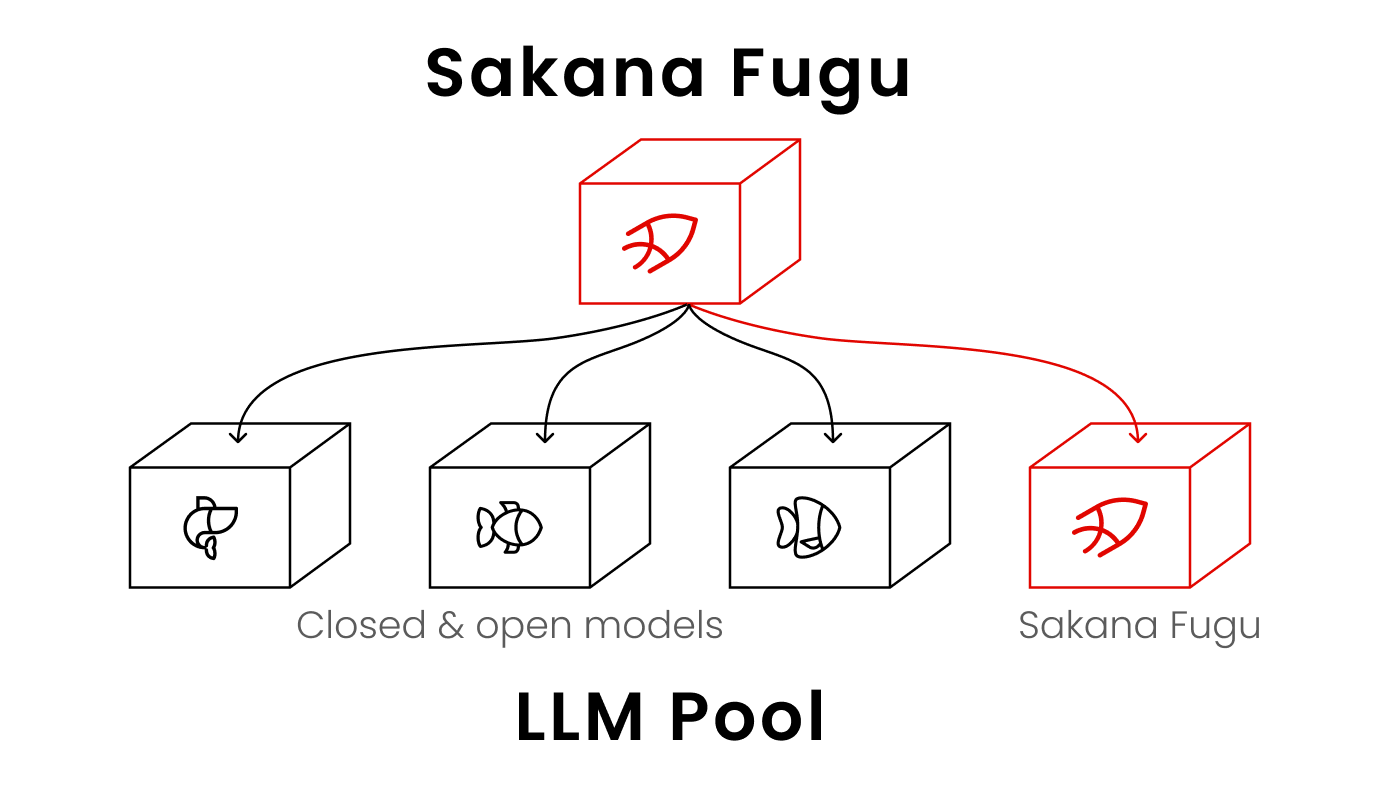
L'architecture de Fugu repose sur deux travaux de recherche soumis à ICLR 2026 : TRINITY et Conductor. TRINITY utilise un coordinateur léger dit "évolutionnaire" qui assigne aux différents LLM du pool l'un de trois rôles : Thinker (réflexion), Worker (exécution) ou Verifier (vérification), selon la nature de la tâche — codage, mathématiques, raisonnement ou connaissance générale. Conductor, lui, est entraîné par reinforcement learning pour découvrir des stratégies de coordination en langage naturel, en concevant des patterns de communication inter-agents et des prompts ciblés. L'idée centrale est que le système apprend à orchestrer plutôt que de suivre un workflow prédéfini par des humains.
Le service est proposé en deux variantes. Fugu cible les usages quotidiens avec un équilibre entre performance et latence, et permet à l'utilisateur d'exclure certains fournisseurs de son pool d'agents pour répondre à des contraintes de conformité. Fugu Ultra, en revanche, mobilise un pool plus large d'agents spécialisés et vise la qualité maximale sur des tâches longues et exigeantes : compétitions Kaggle, reproduction de résultats scientifiques, analyse de cybersécurité, investigations brevets et littérature. Le pool de Fugu Ultra est fixe et non modifiable.
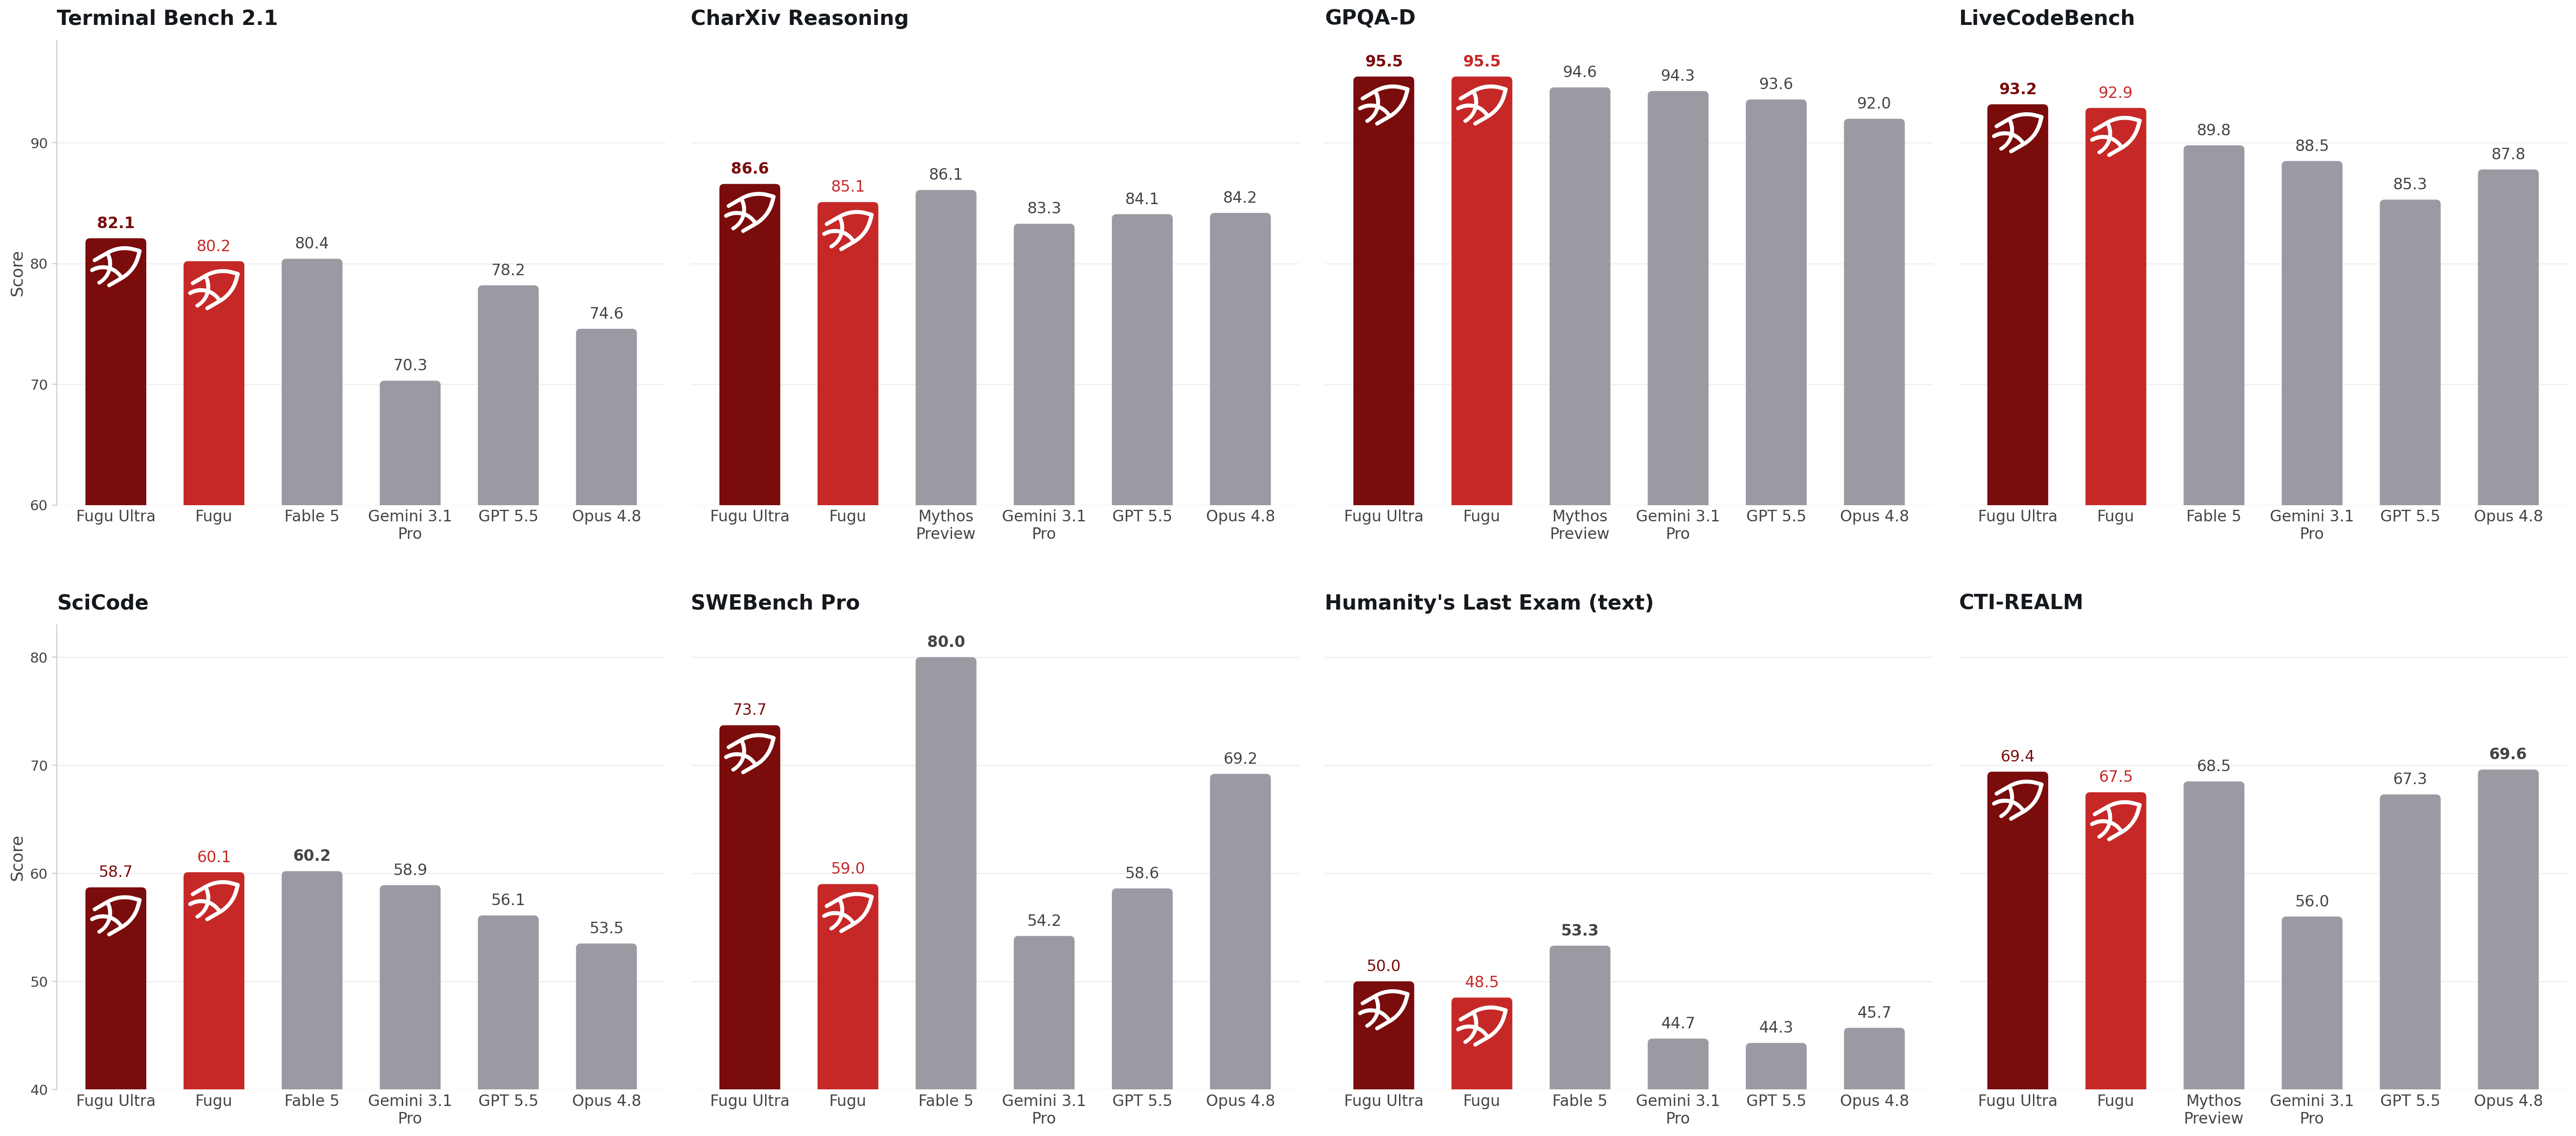
Sur les benchmarks publiés par Sakana AI, Fugu Ultra affiche des scores compétitifs face aux modèles frontier les plus récents. Sur SWE-Bench Pro, il atteint 73,7 contre 69,2 pour Claude Opus 4.8 et 54,2 pour Gemini 3.1 Pro. Sur Humanity's Last Exam, il obtient 50,0, légèrement devant Opus 4.8 à 49,8. Sur LiveCodeBench, Fugu (92,9) et Fugu Ultra (93,2) surpassent GPT 5.5 (85,3) et Gemini 3.1 Pro (88,5). Il convient de noter que ces résultats sont publiés par Sakana AI elle-même, et que Fable 5 et Mythos Preview, cités comme références de comparaison, ne font pas partie du pool d'agents de Fugu car ils ne sont pas publiquement accessibles.
Les benchmarks qualitatifs présentés illustrent des cas d'usage concrets : reconstruction de l'ordre de lecture de manuscrits japonais en écriture chirashigaki de 1610, génération d'un solveur de Rubik's Cube en Python pur sur 300 configurations, conception CAD d'un iris mécanique fonctionnel, ou encore parties d'échecs à l'aveugle contre un moteur Stockfish à 2100 Elo. Ces démonstrations visent à montrer la supériorité de l'orchestration multi-agents sur des tâches nécessitant plusieurs étapes de raisonnement ou de génération de code.
La tarification est transparente : abonnement Standard à 20 dollars par mois pour les usages légers, Pro à 100 dollars (10x la capacité Standard), Max à 200 dollars (20x). En mode pay-as-you-go, Fugu Ultra est facturé à 5 dollars par million de tokens en entrée et 30 dollars en sortie, avec des tarifs plus élevés au-delà de 272 000 tokens de contexte. Sakana AI précise que les frais des différents modèles sous-jacents ne se cumulent pas : seul le tarif du modèle du niveau le plus élevé dans le pool actif est appliqué.
Le service est disponible via une API compatible OpenAI, sans migration de SDK nécessaire. Il n'est pas accessible depuis l'Union européenne ni l'Espace économique européen, en attente de conformité avec le RGPD. Les utilisateurs peuvent opter hors de la collecte de données d'entraînement depuis la console. La fréquence de mise à jour du pool — estimée à environ deux semaines après la sortie publique d'un nouveau modèle frontier — constitue un facteur déterminant pour la pérennité des performances annoncées.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- PleIAs publie Baguettotron-600M, un LLM open-weights de 600 millions de paramètres entraîné sur du françaisPleias · 1 octobre 2026
- Reflection lance Beam, un modèle ouvert américain de 501B paramètres (23B actifs)6 octobre 2026
- PleIAs publie Baguettotron-MoE, un LLM français à architecture MoE sur Hugging FacePleias · 1 octobre 2026
- DeepSeek v4.1 Flash Uncensored sur Hugging FaceHugging Face · 11 septembre 2026
- Quantization des LLM : pourquoi mieux vaut répartir la précision globalement1 septembre 2026
- Sortie du modèle GLM-5.3 UncensoredHugging Face · 2 septembre 2026