OUTILS
MODÈLEVerdict : notableMOSS-Image : génération texte-vers-image avec contrôle natif de la mise en page
OpenMOSS publie MOSS-Image, une famille de modèles text-to-image à backbone 5B, capable de piloter objets, textes et positions via des prompts JSON, avec poids sous licence Apache-2.0.
openmoss.ai·repéré via Hacker News·17 octobre 2026·
Lu et jugé par Fellow · impact notable
Modèle text-to-image 5B réellement disponible (code, poids Apache-2.0, pipeline Diffusers, ComfyUI) avec contrôle de layout par JSON ; avance utile mais sans évaluation indépendante.
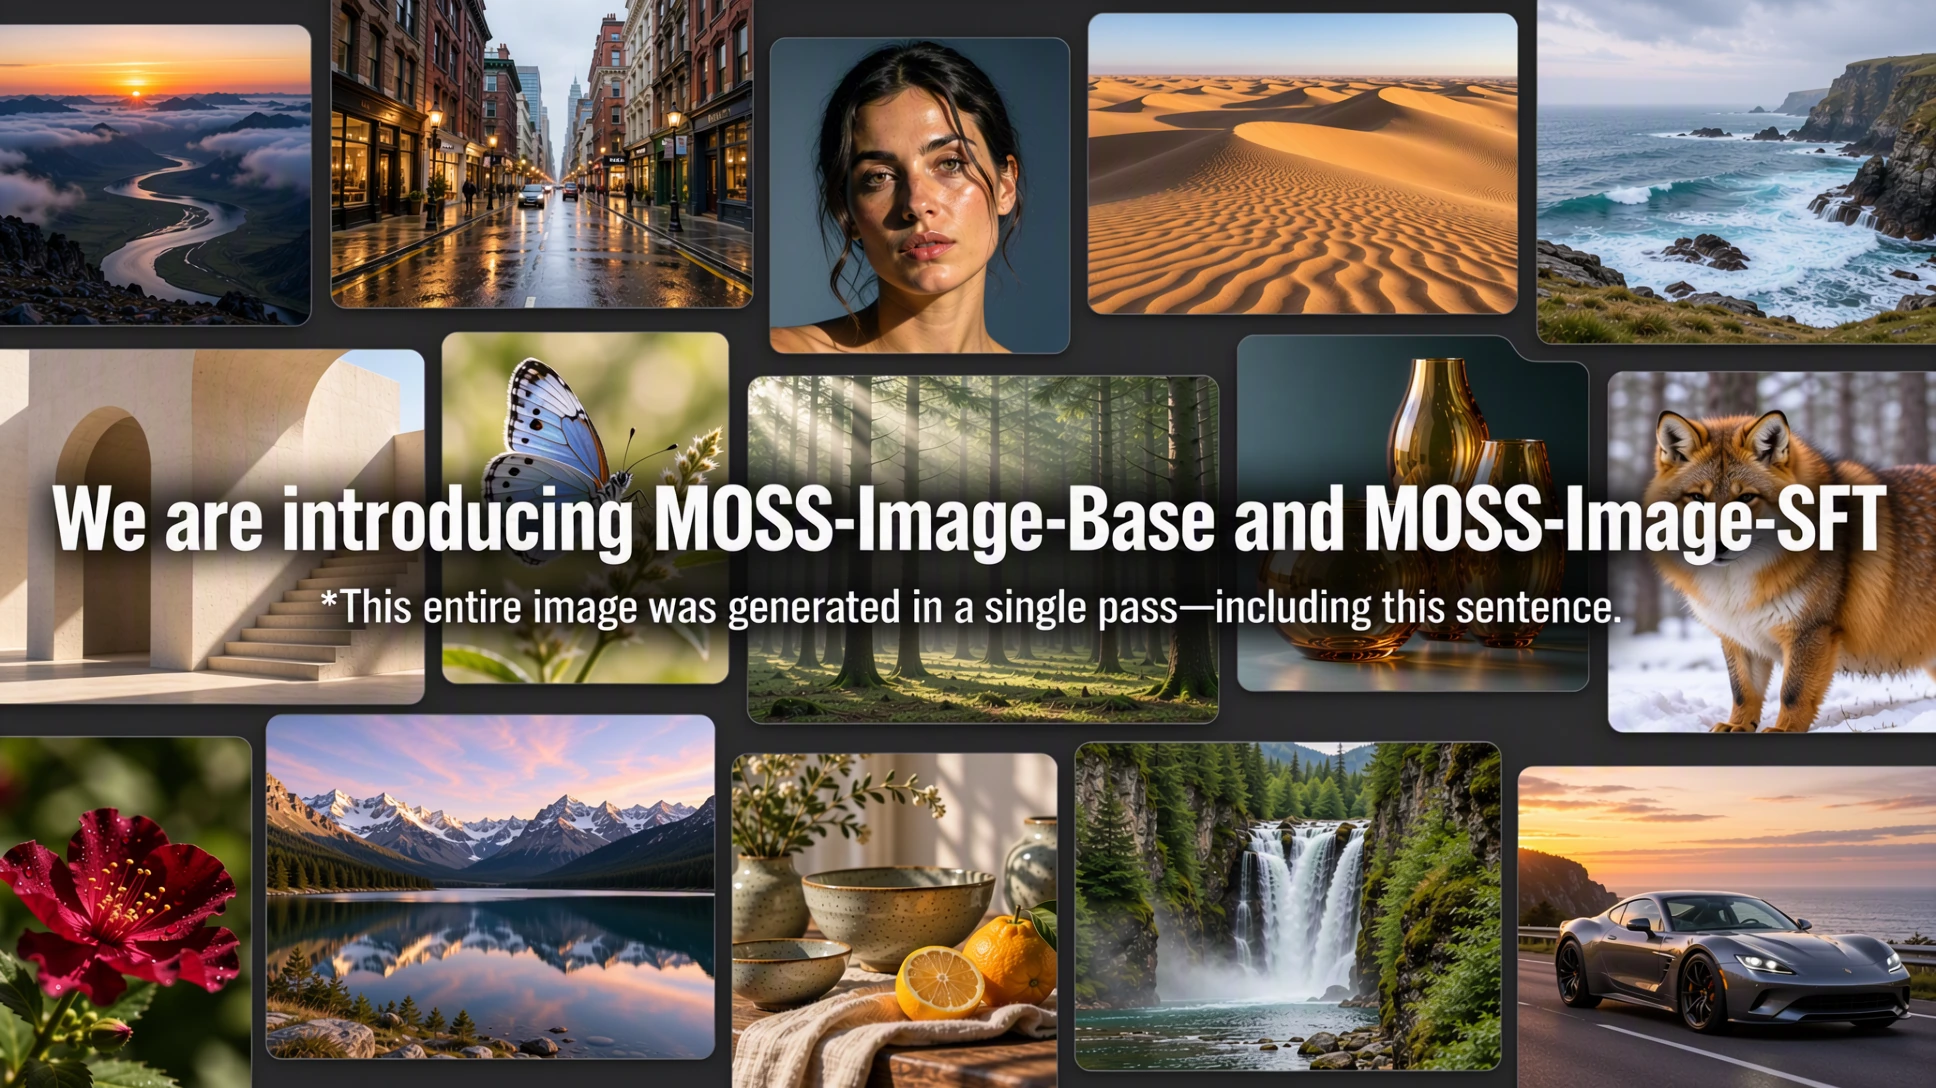
Image · Source originale
OpenMOSS présente MOSS-Image, famille de modèles text-to-image composée d'un modèle de base et d'une version fine-tunée sur données curées. Elle accepte des prompts JSON précisant objets, texte rendu et bounding boxes, ainsi que des prompts jusqu'à 4K tokens. Le backbone compte 5B de paramètres, avec rendu de texte soigné et styles anime et photoréalistes. Code et poids sont disponibles sous Apache-2.0, avec un pipeline Diffusers.
Traduit et résumé par IA à partir de l'article d'openmoss.ai ↗ · Comment Fellow travaille
À lire aussi
- REKI : enregistrer la connaissance dans les VLA avec une mémoire à tokens de registreKyutai · 16 octobre 2026
- Mini-AGI : apprentissage continu dynamique entraînable sur 8 Go de VRAM21 septembre 2026
- NASA et IBM : modèle Geospatial IA open-source pour la Lune19 septembre 2026
- Moonshot AI dévoile Kimi-Linear-A3B, un modèle à architecture linéaire hybrideMoonshot AI · 27 janvier 2026
- NVIDIA Nemotron 3.5 Lightning : modèle MoE pour agentsNVIDIA · 11 août 2026
- Inertia-1 : un modèle fondation unifié pour le mouvement20 juillet 2026