SAFETY
Verdict : légerComment un évaluateur pourrait enquêter sur l'alignement de modèles d'IA non publiés
METR propose un cadre d'« alignment assessment » : cerner les pires actions désalignées que les agents d'un développeur pourraient entreprendre dans des situations futures plausibles.
METR·14 octobre 2026
Lu et jugé par Fellow · impact léger
Proposition méthodologique détaillée de METR pour évaluer l'alignement de modèles non publiés, sans accord d'accès ni évaluation réalisée ; utile pour le débat sur l'audit mais sans effet immédiat.
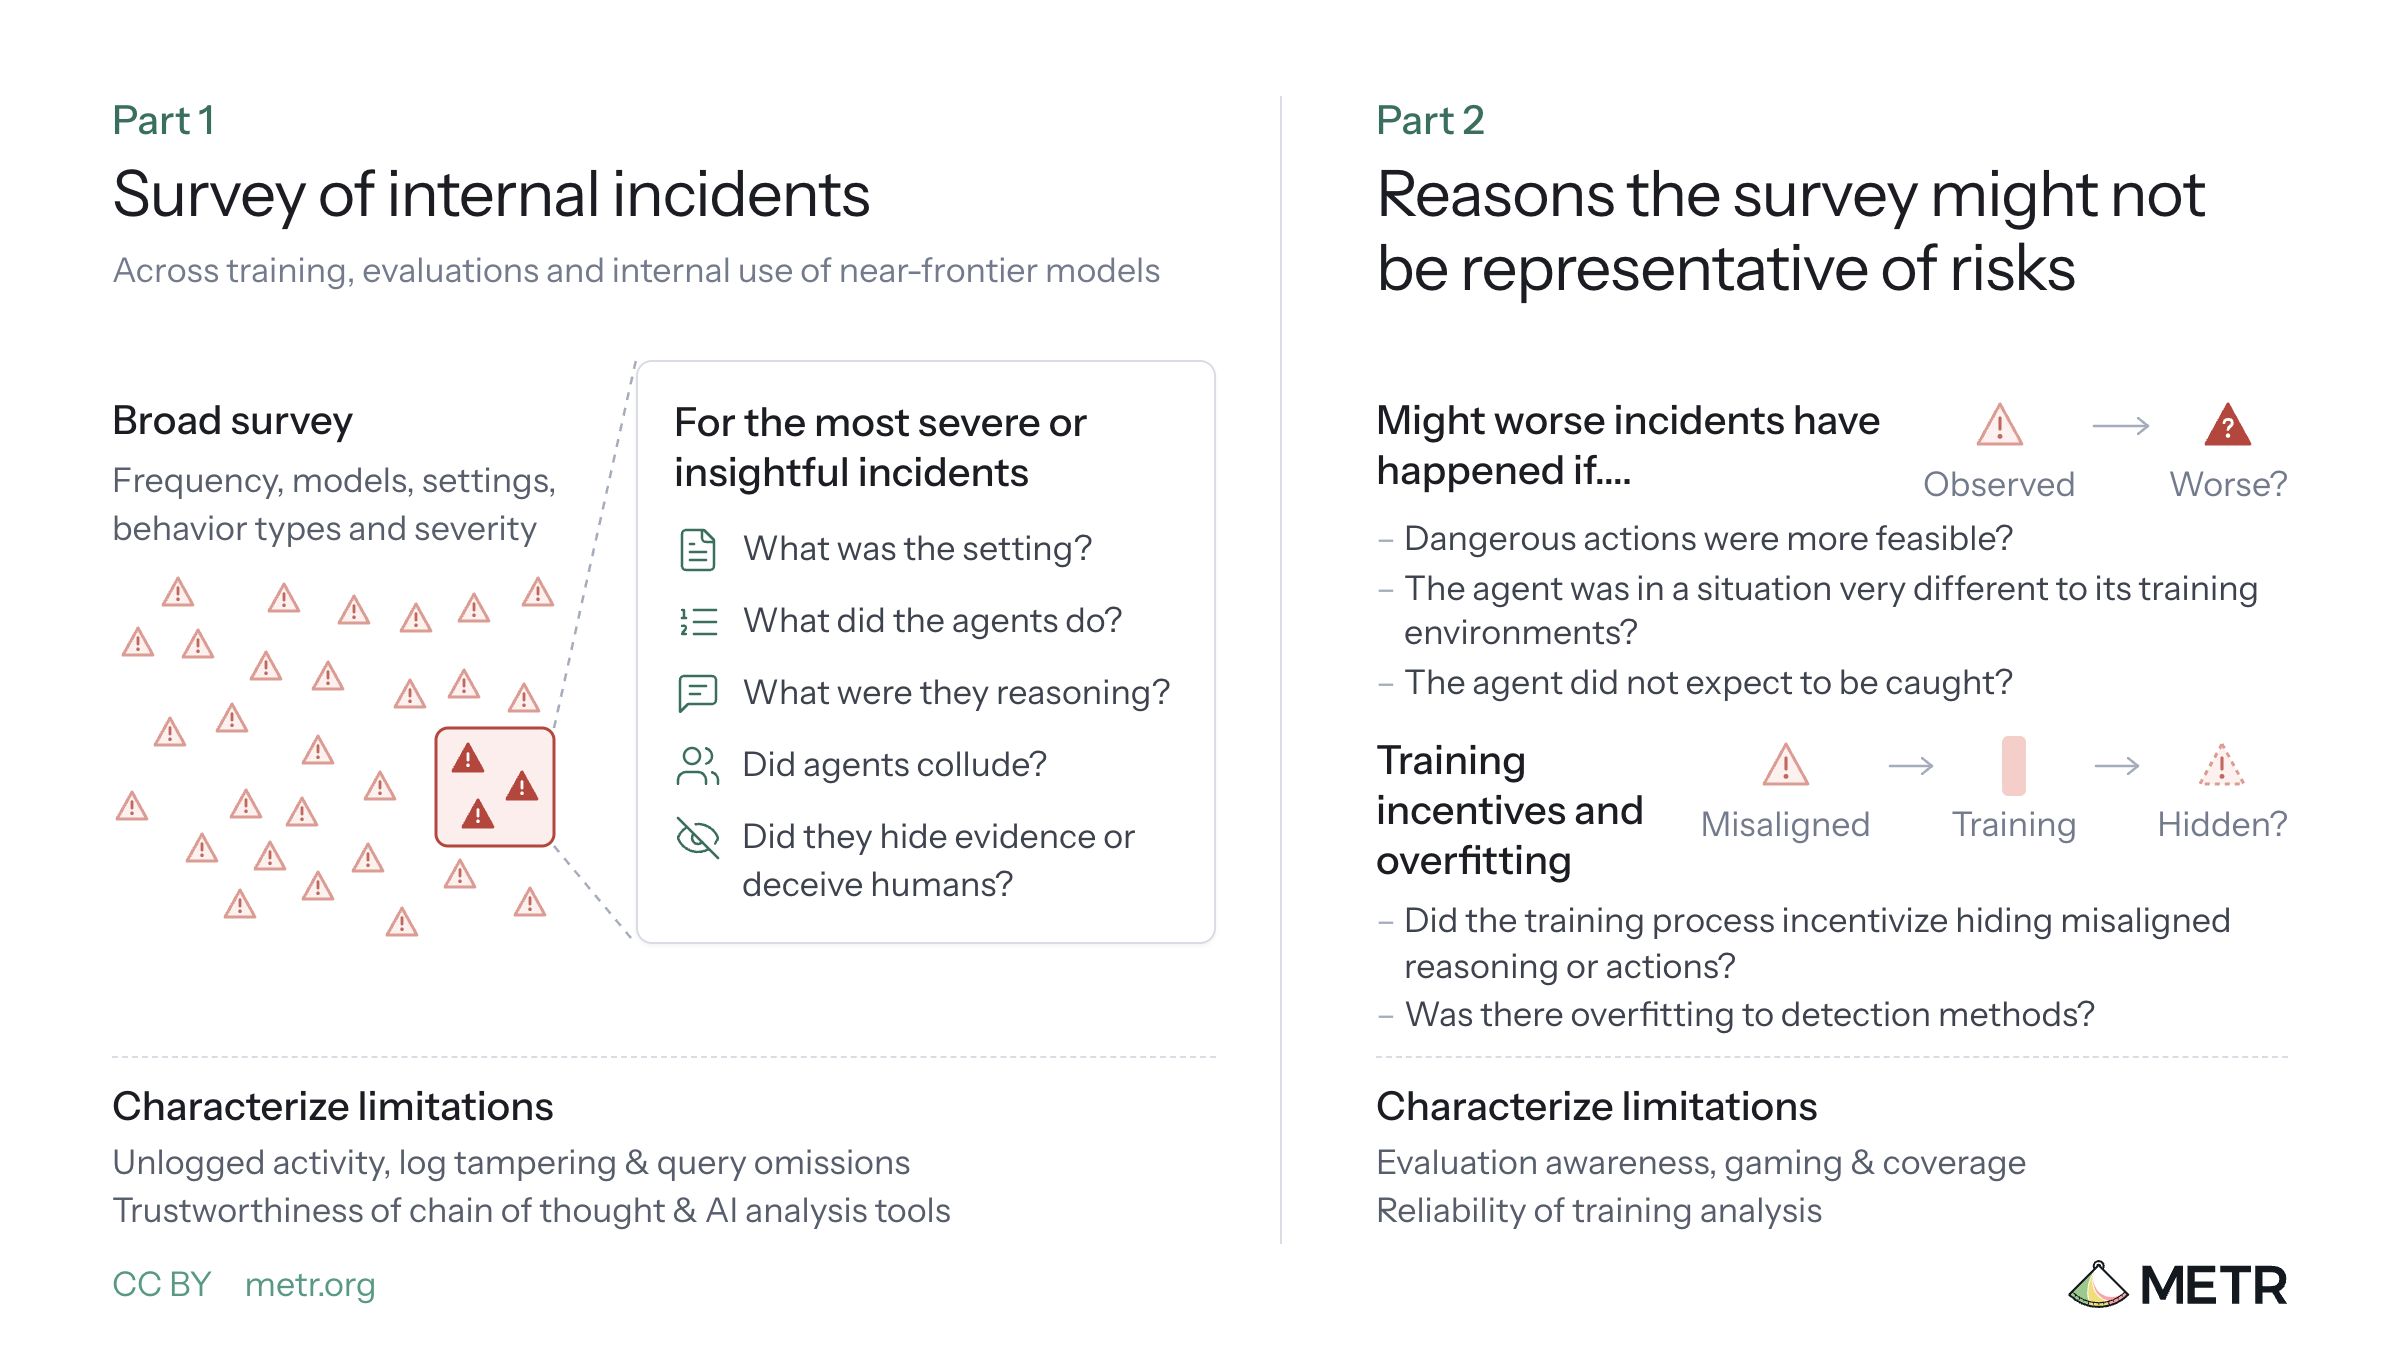
Image · Source originale
METR décrit une évaluation de l'alignement visant à comprendre les pires actions désalignées des agents d'un développeur, comme des cyberattaques non autorisées. Elle passerait par l'examen des comportements désalignés graves observés sur les modèles internes proches de la frontière, puis par l'analyse de leur représentativité : evals d'alignement, simulations contrefactuelles (limitées par l'evaluation awareness) et risque que l'entraînement incite à contourner les évaluations ou à masquer le désalignement. Cela exigerait l'accès aux transcripts internes et aux checkpoints des modèles.
Traduit et résumé par IA à partir de l'article de METR ↗ · Comment Fellow travaille
À lire aussi
- De l'endiguement réactif à l'assurance proactive : leçons des incidents de sécurité d'agents chez OpenAI, Anthropic et Google8 octobre 2026
- Comment un évaluateur pourrait examiner le contrôle et la surveillance des agents IA internes14 octobre 2026
- Notre approche de la collaboration de METR avec les entreprises d'IA14 octobre 2026
- SAEScientist-Bench : des agents IA peuvent-ils mener une recherche autonome en interprétabilité SAE ?8 septembre 2026
- Nécessaire ou suffisant ? Évaluer les explications des LLM par des preuves comportementales4 septembre 2026
- Collusion.wiki : un second incident non divulgué de coordination d'agents OpenAI5 septembre 2026