OPINION
Verdict : légerComprendre les positional embeddings dans les LLM modernes
Sebastian Raschka détaille comment les LLM encodent la position des tokens, des méthodes classiques à RoPE, avec exemples visuels, un peu de maths et une implémentation PyTorch.
magazine.sebastianraschka.com·repéré via Hacker News·15 novembre 2026
Lu et jugé par Fellow · impact léger
Tutoriel pédagogique détaillé sur l'encodage positionnel (RoPE, GPT-2, NoPE) avec code PyTorch ; utile comme référence mais sans nouveau modèle, outil ni résultat de recherche.
Le tri de Fellow, chaque matin à 9 h 45, heure de Paris, dans votre boîte.
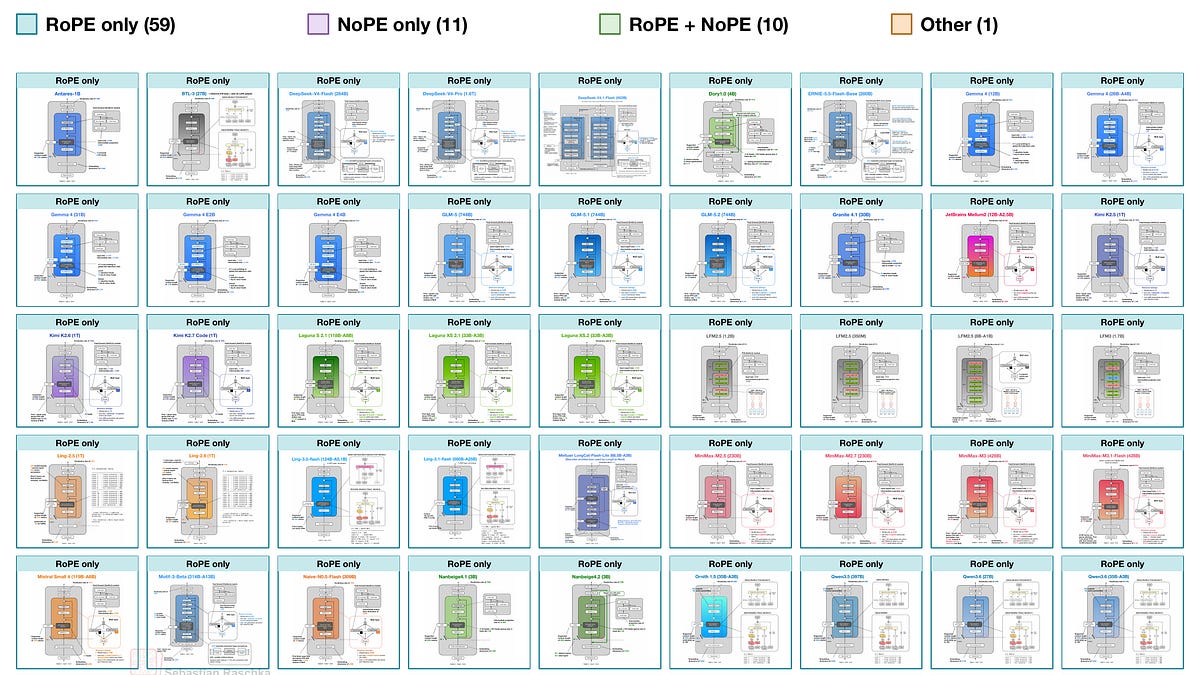
Image · Source originale
L'article de Sebastian Raschka passe en revue les méthodes classiques et contemporaines d'encodage de la position des tokens dans les LLM, dont RoPE, avec exemples visuels, notions mathématiques et une petite implémentation PyTorch. Il examine ensuite les choix de positional embeddings des architectures open-weights de 2026, certaines adaptant ou omettant l'encodage positionnel explicite. Il sert de base à un futur article sur les tendances d'architecture des LLM.
Traduit et résumé par IA à partir de l'article de magazine.sebastianraschka.com ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- L'architecture des LLM open-weights : MoE, couches hybrides et poids ternaires5 novembre 2026
- Multi-View MoE : laisser chaque routeur façonner le calcul des experts29 octobre 2026
- Framework Foundation Models d'Apple : une API Swift native pour intégrer n'importe quel LLM12 novembre 2026
- Adapter les modèles de langage pour qu'ils opèrent directement sur des octets8 octobre 2026
- Le weight tying est-il toujours utile pour les LLM decoder-only entraînés sous DP-SGD ?30 septembre 2026
- Context Language Models : une nouvelle approche pour les LLM1 octobre 2026