OUTILS
MODÈLEVerdict : notableNaiveAI promet 2 100 tokens par seconde : que vaut son modèle en code ?
Latent Space lance une série de tests indépendants avec Naive-N0.5-Flash, un modèle open-weights dédié au code, dérivé de MiMo-V2.5 de Xiaomi et optimisé pour le débit.
Latent Space (Swyx)·Gabriele Beltramo·10 novembre 2026
Lu et jugé par Fellow · impact notable
Modèle open-weights de code réellement testé de façon indépendante (30 questions, 3 applications) face à DeepSeek et GLM, avec des chiffres de latence mais sans évaluation de la justesse.
Le tri de Fellow, chaque matin à 9 h 45, heure de Paris, dans votre boîte.
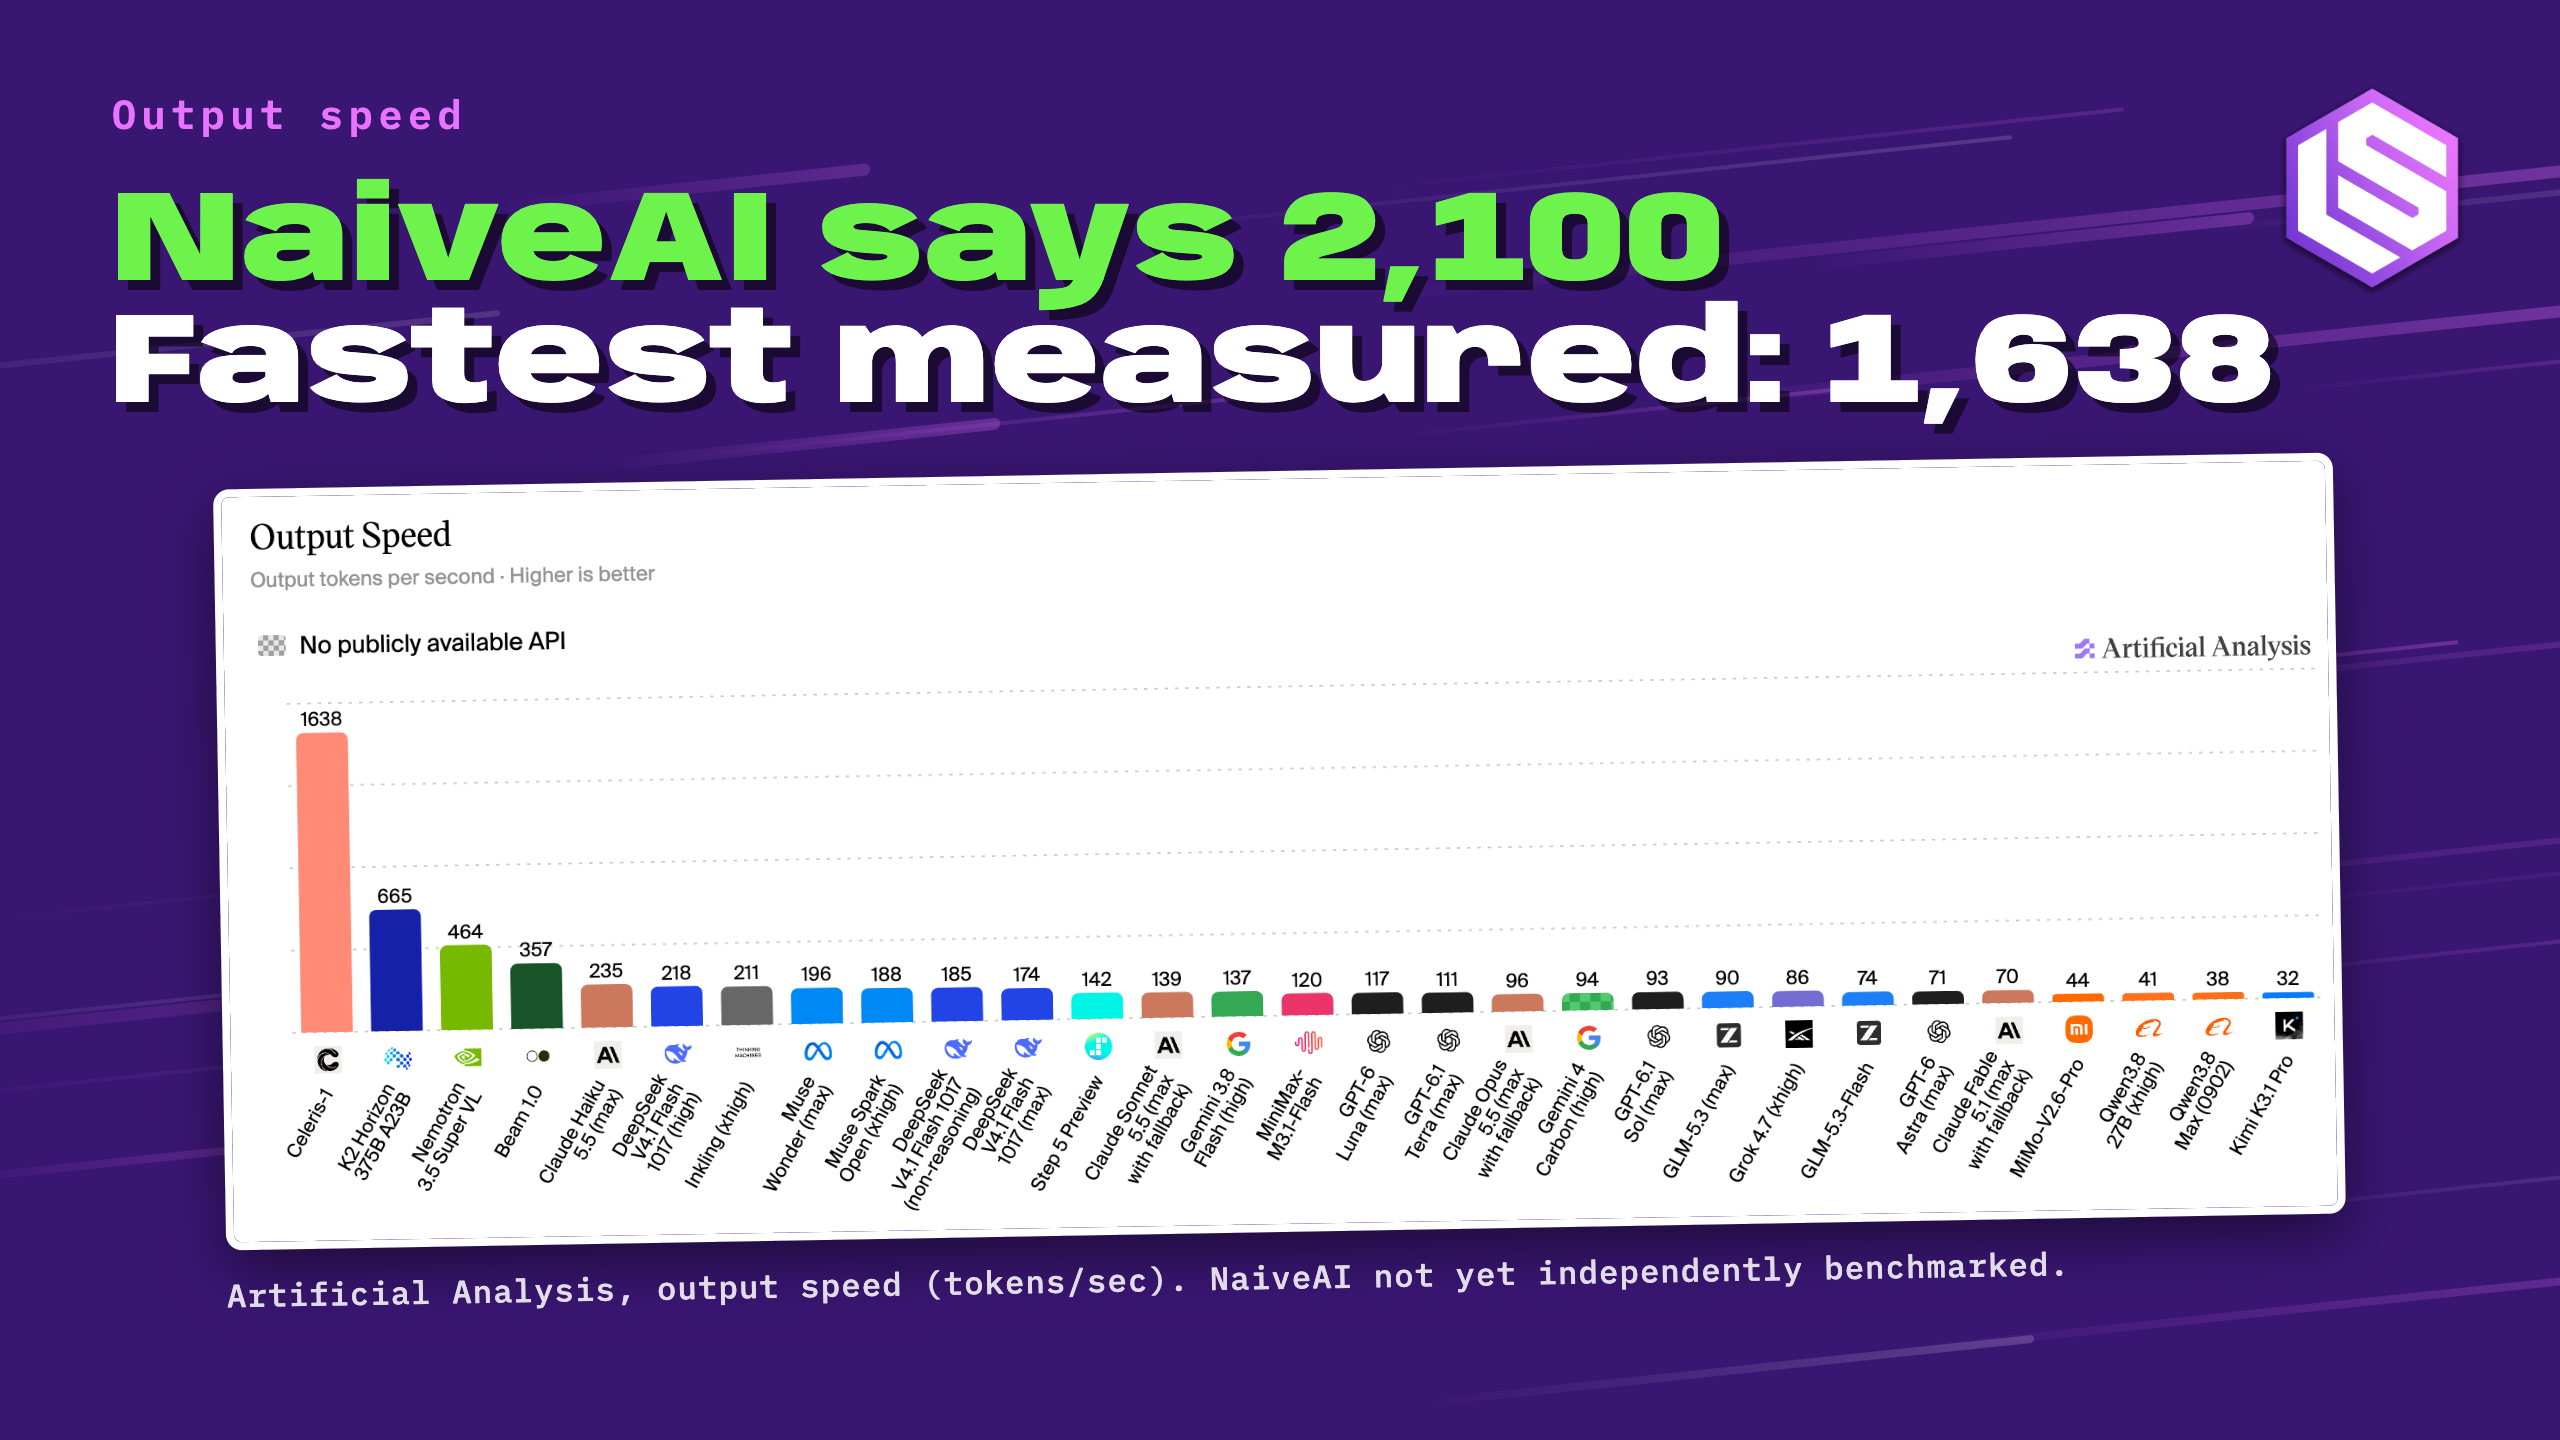
Image · Source originale
Naive-N0.5-Flash est un modèle open-weights développé par la société chinoise NaiveAI pour les tâches de code, optimisé pour générer un maximum de tokens par seconde, avec son moteur d'inférence NaiveRT. Il dérive de MiMo-V2.5 (MoE de 310B paramètres dont 15B actifs, entraîné sur 48T tokens), adapté à DeepSeek Sparse Attention via environ 3,25T tokens supplémentaires, dont 3T à 1M de contexte. NaiveAI vise à terme l'auto-amélioration récursive.
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Beam : un modèle ouvert de 501 milliards de paramètres à posséder, personnaliser et déployerHugging Face · 16 octobre 2026
- Un guide ouvert de l'ingénierie d'inférence pour les platform engineers10 novembre 2026
- Vos experts ont des partenaires : HOPE pour les garder ensemble lors de l'élagage des MoEHugging Face · 9 novembre 2026
- Reflection lance Beam, un modèle ouvert américain de 501B paramètres (23B actifs)6 octobre 2026
- Xiaomi lance MiMo-V2.6-Pro, nouveau modèle open-weights 1T-A42B entraîné pour 3 M$22 septembre 2026
- PleIAs publie Baguettotron-MoE, un LLM français à architecture MoE sur Hugging FacePleias · 1 octobre 2026