Gemma 4 accéléré : inférence plus rapide grâce aux multi-token prediction drafters
Google dévoile une technique de multi-token prediction pour Gemma 4, réduisant la latence d'inférence sans dégradation de qualité.

Traduit et résumé par IA à partir de l'article de Google ↗ · Comment Fellow travaille
Développement
· Généré par Claude Sonnet 4.6↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
La génération autoregressive standard des LLM souffre d'un goulot d'étranglement structurel : le processeur consacre l'essentiel de son temps à transférer des milliards de paramètres depuis la VRAM vers les unités de calcul pour produire un unique token à chaque itération. Cette contrainte de bande passante mémoire laisse une part importante de la capacité de calcul disponible inexploitée, ce qui se traduit par une latence élevée, particulièrement sensible sur du matériel grand public.
Google répond à ce problème avec des drafters MTP (Multi-Token Prediction) pour la famille Gemma 4, disponibles depuis le 5 mai 2026 sous licence Apache 2.0. Le principe repose sur le speculative decoding, une technique publiée par des chercheurs de Google dans les travaux « Fast Inference from Transformers via Speculative Decoding ». Le mécanisme dissocie la génération de tokens de leur vérification : un modèle drafter léger prédit en parallèle plusieurs tokens futurs, tandis que le modèle cible principal — par exemple Gemma 4 31B — vérifie l'ensemble de cette séquence en un seul forward pass. Si le modèle cible valide les tokens proposés, l'application peut produire la séquence complète plus un token supplémentaire dans le temps qu'il faudrait normalement pour en générer un seul.
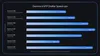
Les gains mesurés atteignent jusqu'à un facteur 3x en termes de tokens par seconde, selon les tests conduits sur LiteRT-LM, MLX, Hugging Face Transformers et vLLM. Google insiste sur l'absence de dégradation de qualité : la vérification finale restant assurée par le modèle cible, les capacités de raisonnement et la précision demeurent identiques à l'inférence standard.
Plusieurs optimisations architecturales permettent d'atteindre ces performances. Les drafters réutilisent directement les activations du modèle cible et partagent son KV cache, évitant tout recalcul de contexte déjà établi. Pour les modèles edge E2B et E4B, où le calcul des logits finaux constitue lui-même un goulot, une technique de clustering efficace dans l'embedder a été introduite pour accélérer davantage la génération. Des optimisations spécifiques au matériel ont également été étudiées : le modèle MoE 26B présente des défis de routage particuliers à une taille de batch de 1 sur Apple Silicon, mais l'augmentation vers des batch sizes de 4 à 8 permet d'obtenir jusqu'à 2,2x de gain de vitesse. Des gains similaires sont observés sur les GPU Nvidia A100 à plus grand batch.
L'annonce intervient quelques semaines seulement après le lancement de Gemma 4, qui revendique plus de 60 millions de téléchargements dans les premières semaines. Les cas d'usage ciblés par les drafters MTP couvrent un spectre large : assistants de codage, workflows agentiques nécessitant une planification multi-étapes rapide, applications vocales en temps quasi réel, et exécution on-device sur terminaux mobiles ou ordinateurs personnels. Sur ce dernier point, Google met en avant la possibilité de faire tourner les modèles Dense 31B et MoE 26B sur des GPU grand public à des vitesses inédites, tout en mentionnant un impact positif sur la consommation batterie pour les modèles edge.
Les poids des drafters MTP sont accessibles sur Hugging Face et Kaggle, et compatibles avec les frameworks Transformers, MLX, vLLM, SGLang et Ollama. Un accès direct est également proposé via Google AI Edge Gallery pour Android et iOS. Google a par ailleurs publié un document technique détaillé couvrant l'architecture visuelle, le partage de KV cache et le fonctionnement des embedders.
La question ouverte principale porte sur la généralisation de l'approche : les performances annoncées dépendent du taux d'acceptation des tokens proposés par le drafter, lui-même variable selon le type de texte généré. Des tâches très créatives ou peu prévisibles pourraient réduire mécaniquement ce taux et donc les gains effectifs. La robustesse de l'approche sur l'ensemble des cas d'usage reste à évaluer indépendamment dans des contextes de production réels.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Analyser des documents techniques avec Deep ReviewGoogle · 14 octobre 2026
- Ancrer les agents IA dans la réalité biologique : les briques des laboratoires autonomesGoogle · 16 octobre 2026
- Google lance CC, un agent IA conçu pour les familles et les groupesGoogle · 23 septembre 2026
- Google accélère la science et améliore les vies grâce à l'IAGoogle · 15 septembre 2026
- Nouvelles fonctionnalités football dans Google SearchGoogle · 9 septembre 2026
- Google célèbre les 25 ans de Google Images et de la recherche visuelleGoogle · 14 juillet 2026