Specsmaxxing : écrire des specs en YAML pour surmonter la psychose de l'IA
Un développeur explique pourquoi structurer ses instructions en YAML aide à mieux contrôler les agents IA et à éviter les dérives comportementales.
Traduit et résumé par IA à partir de l'article d'acai.sh ↗ · Comment Fellow travaille
Développement
· Généré par IA↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
Le phénomène est bien connu des développeurs qui travaillent avec des agents IA : un modèle produit un résultat satisfaisant, puis dérive progressivement dès qu'un cas limite est ajouté, qu'une session change, ou que le contexte s'allonge. L'auteur de ce billet nomme cette instabilité la « psychose de l'IA » et propose une réponse méthodologique : le specsmaxxing, soit la rédaction de spécifications aussi exhaustives et structurées que possible, dans un format YAML plutôt qu'en prose libre.
Le constat de départ est que la documentation en markdown — README, AGENTS.md, architecture.md — constitue déjà un progrès réel par rapport aux simples prompts, mais atteint rapidement ses limites. Les exigences rédigées en langage naturel restent difficiles à référencer précisément, à tracer dans le code, et à maintenir cohérentes entre plusieurs branches ou implémentations. Le manque de structure rend également difficile toute forme de validation automatisée.
La solution proposée repose sur un format maison appelé feature.yaml, qui organise les exigences fonctionnelles en composants numérotés. Chaque requirement reçoit un identifiant stable appelé ACID (Acceptance Criteria ID), par exemple my-feature.ENG.2. L'idée centrale est venue d'une observation empirique : un agent avait spontanément commencé à annoter le code source avec des références aux exigences du spec, créant une traçabilité bidirectionnelle entre la spécification et l'implémentation. L'auteur a formalisé cette pratique et en a fait le cœur de son outil.
Le workflow proposé se décompose en quatre étapes. D'abord, rédiger un spec en feature.yaml pour chaque fonctionnalité, en se concentrant sur les comportements fonctionnels et les contraintes techniques, en excluant délibérément les détails d'interface ou les ajustements cosmétiques. Ensuite, transmettre ce spec à l'agent avec un prompt standardisé pour que celui-ci implémente et teste chaque exigence en référençant les ACIDs. Puis, utiliser un dashboard centralisé pour suivre l'état d'avancement par requirement — marqué comme Completed, Accepted ou Rejected — plutôt que de relire les diffs fichier par fichier. Enfin, itérer en modifiant le spec en amont plutôt qu'en repromptant à la chaîne.
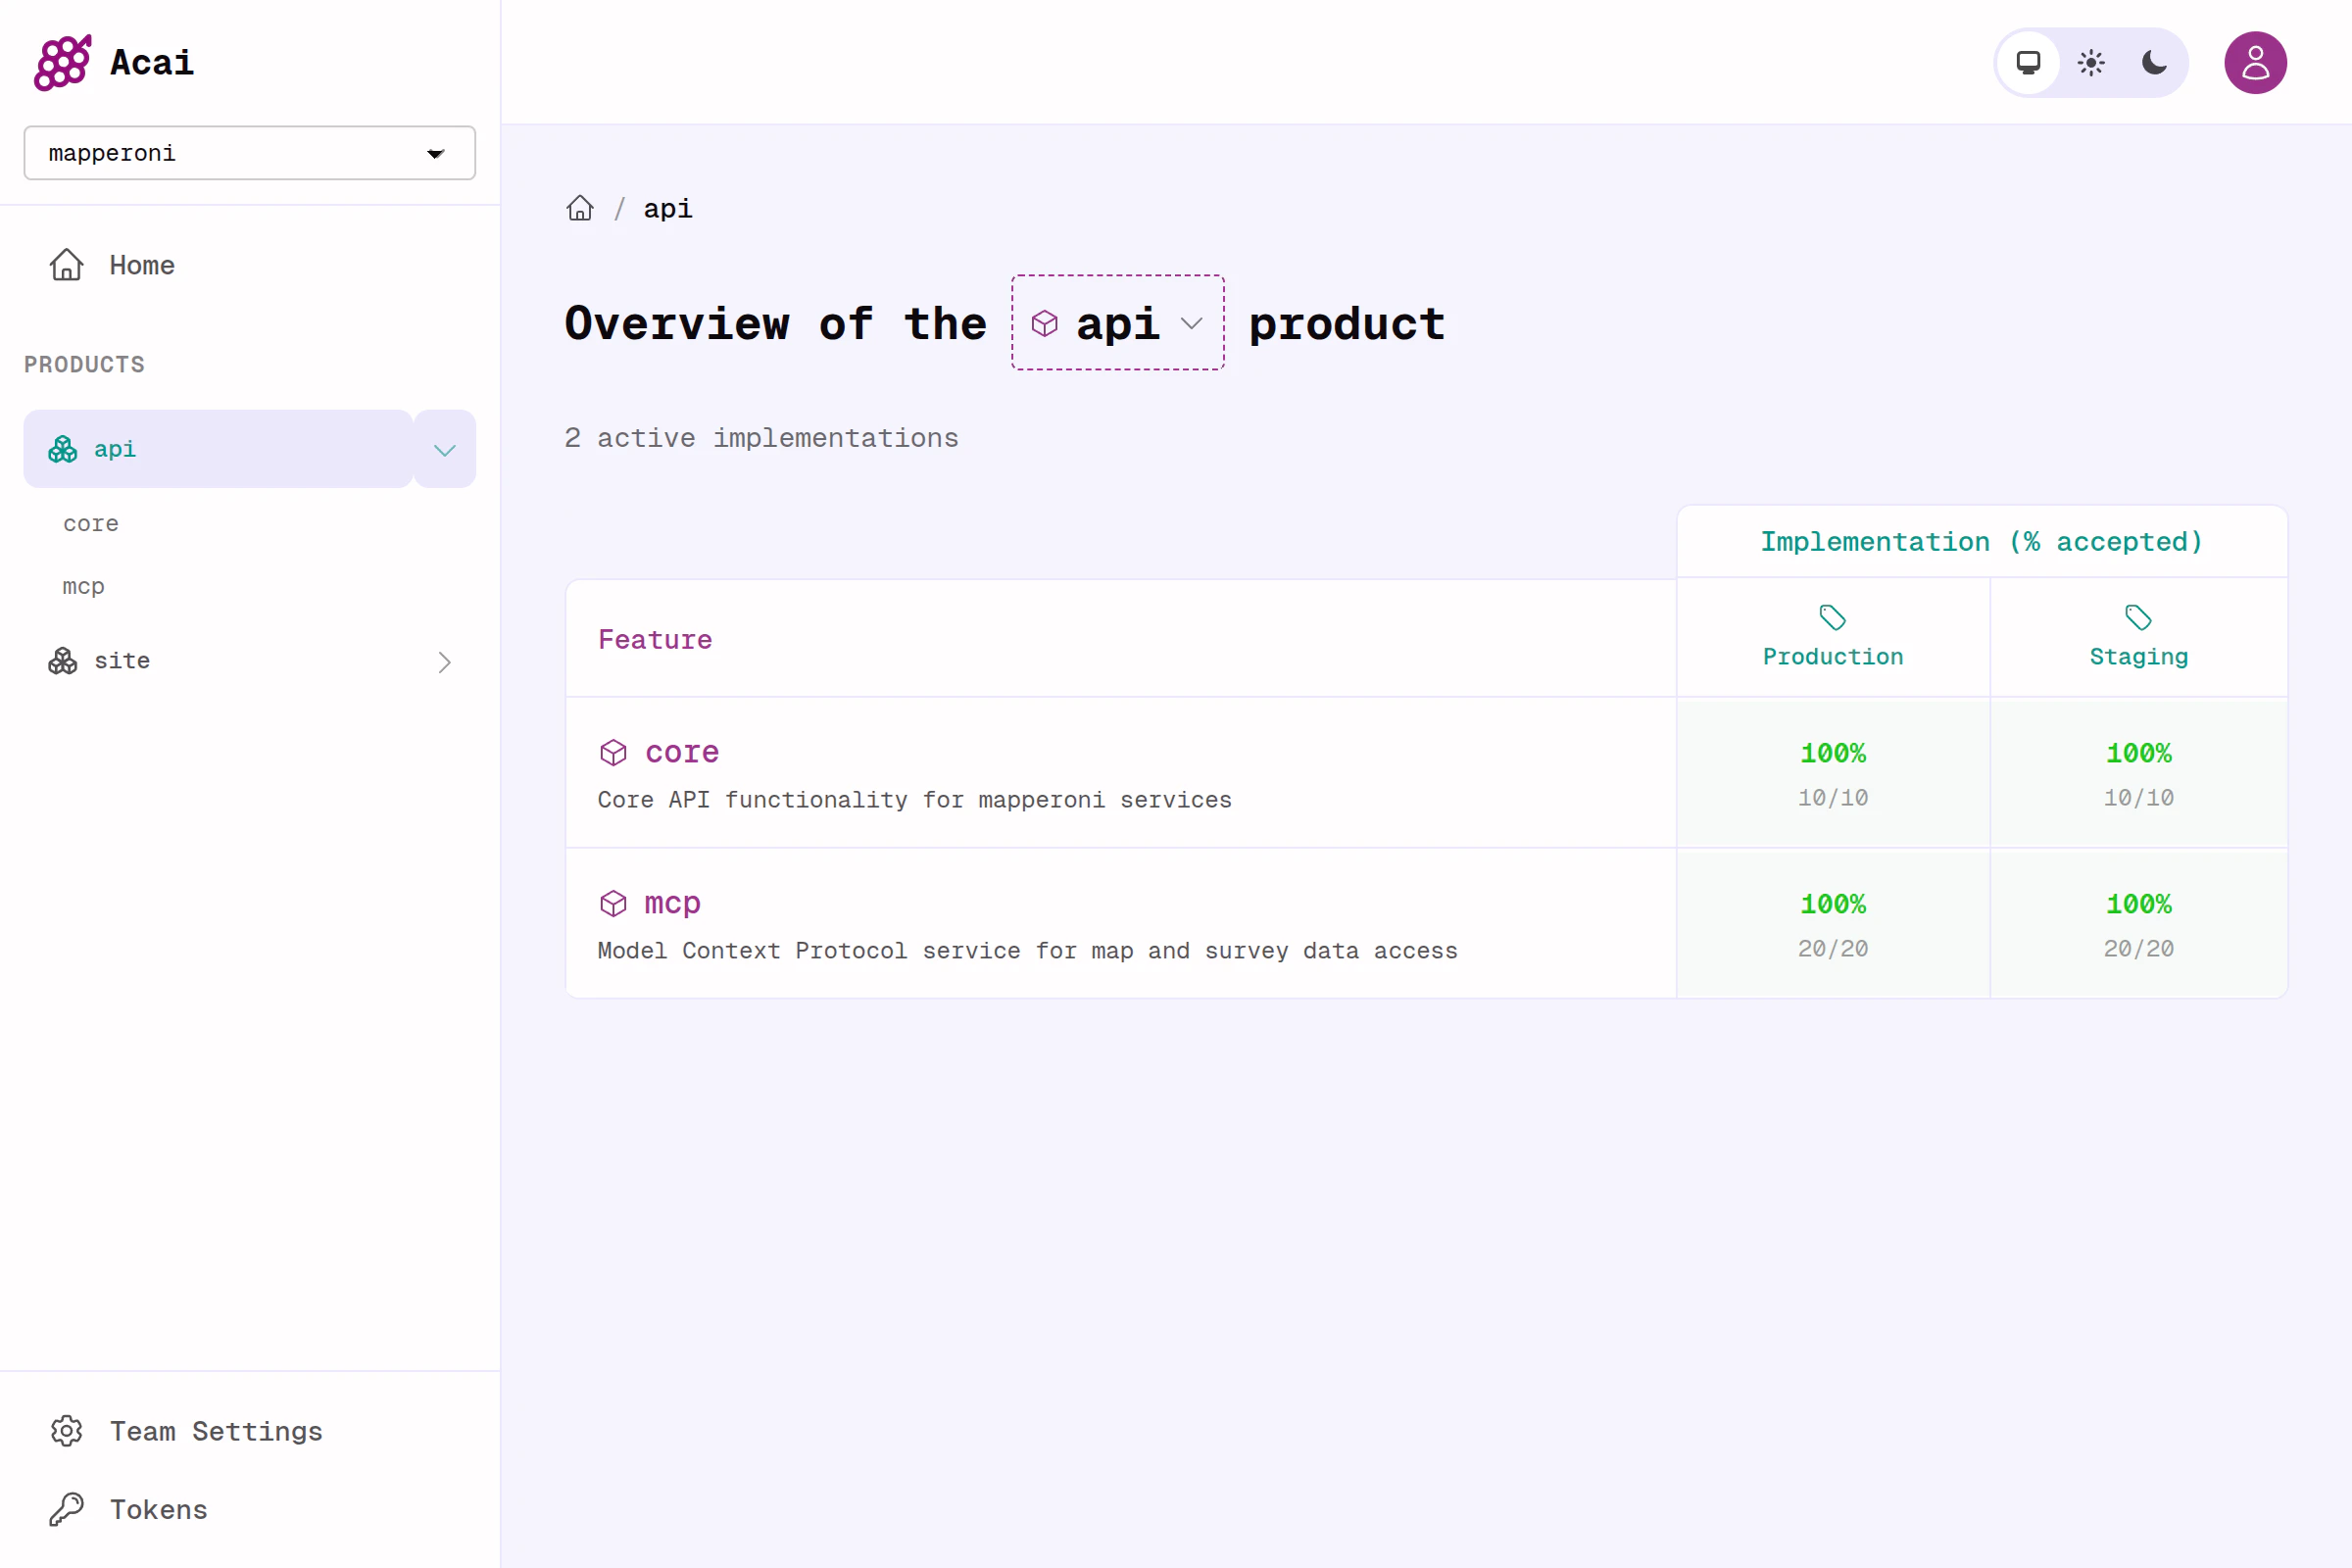
L'auteur a publié un toolkit open source sous licence Apache 2.0 — acai.sh — comprenant un CLI disponible via npm, une API REST et une interface web hébergée gratuitement. Le code source est disponible sur GitHub. L'outil permet notamment de pousser les specs et leurs références dans le code vers un dashboard partagé, ce qui facilite la collaboration et la revue entre humains ou entre agents.
Sur le plan des perspectives, l'auteur esquisse une trajectoire en trois étapes. La première, le specsmaxxing, est déjà à l'œuvre. La deuxième, qu'il nomme testmaxxing, consiste à investir massivement dans l'automatisation QA à mesure que la génération de code devient plus rapide que sa relecture. La troisième envisage des pipelines entièrement réactifs, où un LLM serait déclenché automatiquement par un test rouge ou une alerte, sans intervention humaine, dès lors que les specs sont suffisamment précises et le pipeline de validation fiable.
Plusieurs questions restent ouvertes. La numérotation stable des ACIDs impose une discipline de maintenance : tout changement dans le spec nécessite une mise à jour correspondante dans le code. L'auteur reconnaît cette contrainte mais la présente comme inhérente à l'approche spec-first. Par ailleurs, la comparaison avec des outils concurrents — GitHub SpecKit, OpenSpec, Kiro, Traycer.ai — est présentée comme partielle et potentiellement biaisée, l'auteur admettant un biais Not Invented Here. La différenciation principale revendiquée est le suivi de la couverture par acceptance criteria plutôt que par tests unitaires, et la capacité à tracer une même exigence à travers plusieurs implémentations, dépôts ou branches simultanément. L'ambition déclarée est que la spec, et non le code, devienne l'artefact principal autour duquel s'organise le développement logiciel.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Apprendre un filtrage de mémoire personnalisé à partir d'un feedback différé et unilatéral16 octobre 2026
- Utiliser un LLM pour produire un score de confiance est une mauvaise idée21 octobre 2026
- Quant-Arena : un benchmark pour les agents LLM en recherche de trading quantitatif21 octobre 2026
- Le routeur intérieur : révéler le routage natif de compétences d'un LLM figé14 septembre 2026
- Embodied-BenchForge : workflow agentic pour benchmarks embarqués11 septembre 2026
- Comment écrire avec un LLM17 septembre 2026