RECHERCHE
PAPIERVerdict : notableRéplication à grande échelle de résultats anciens sur les LLM avec des modèles récents
Sur 50 constats largement cités testés sur 20 modèles, 44 % sont désormais périmés et 34 % nettement affaiblis : la durée de vie des résultats sur les LLM serait très courte.
zou-group.github.io·repéré via Hacker News·3 novembre 2026·
Lu et jugé par Fellow · impact notable
Étude systématique et documentée (50 constats, 20 modèles, protocole et tendances ajustées publiés) montrant que 44 % des résultats LLM expirent ; signal méthodologique utile, mais un seul panel et un design minimal par constat.
Le tri de Fellow, chaque matin à 9 h 45, heure de Paris, dans votre boîte.
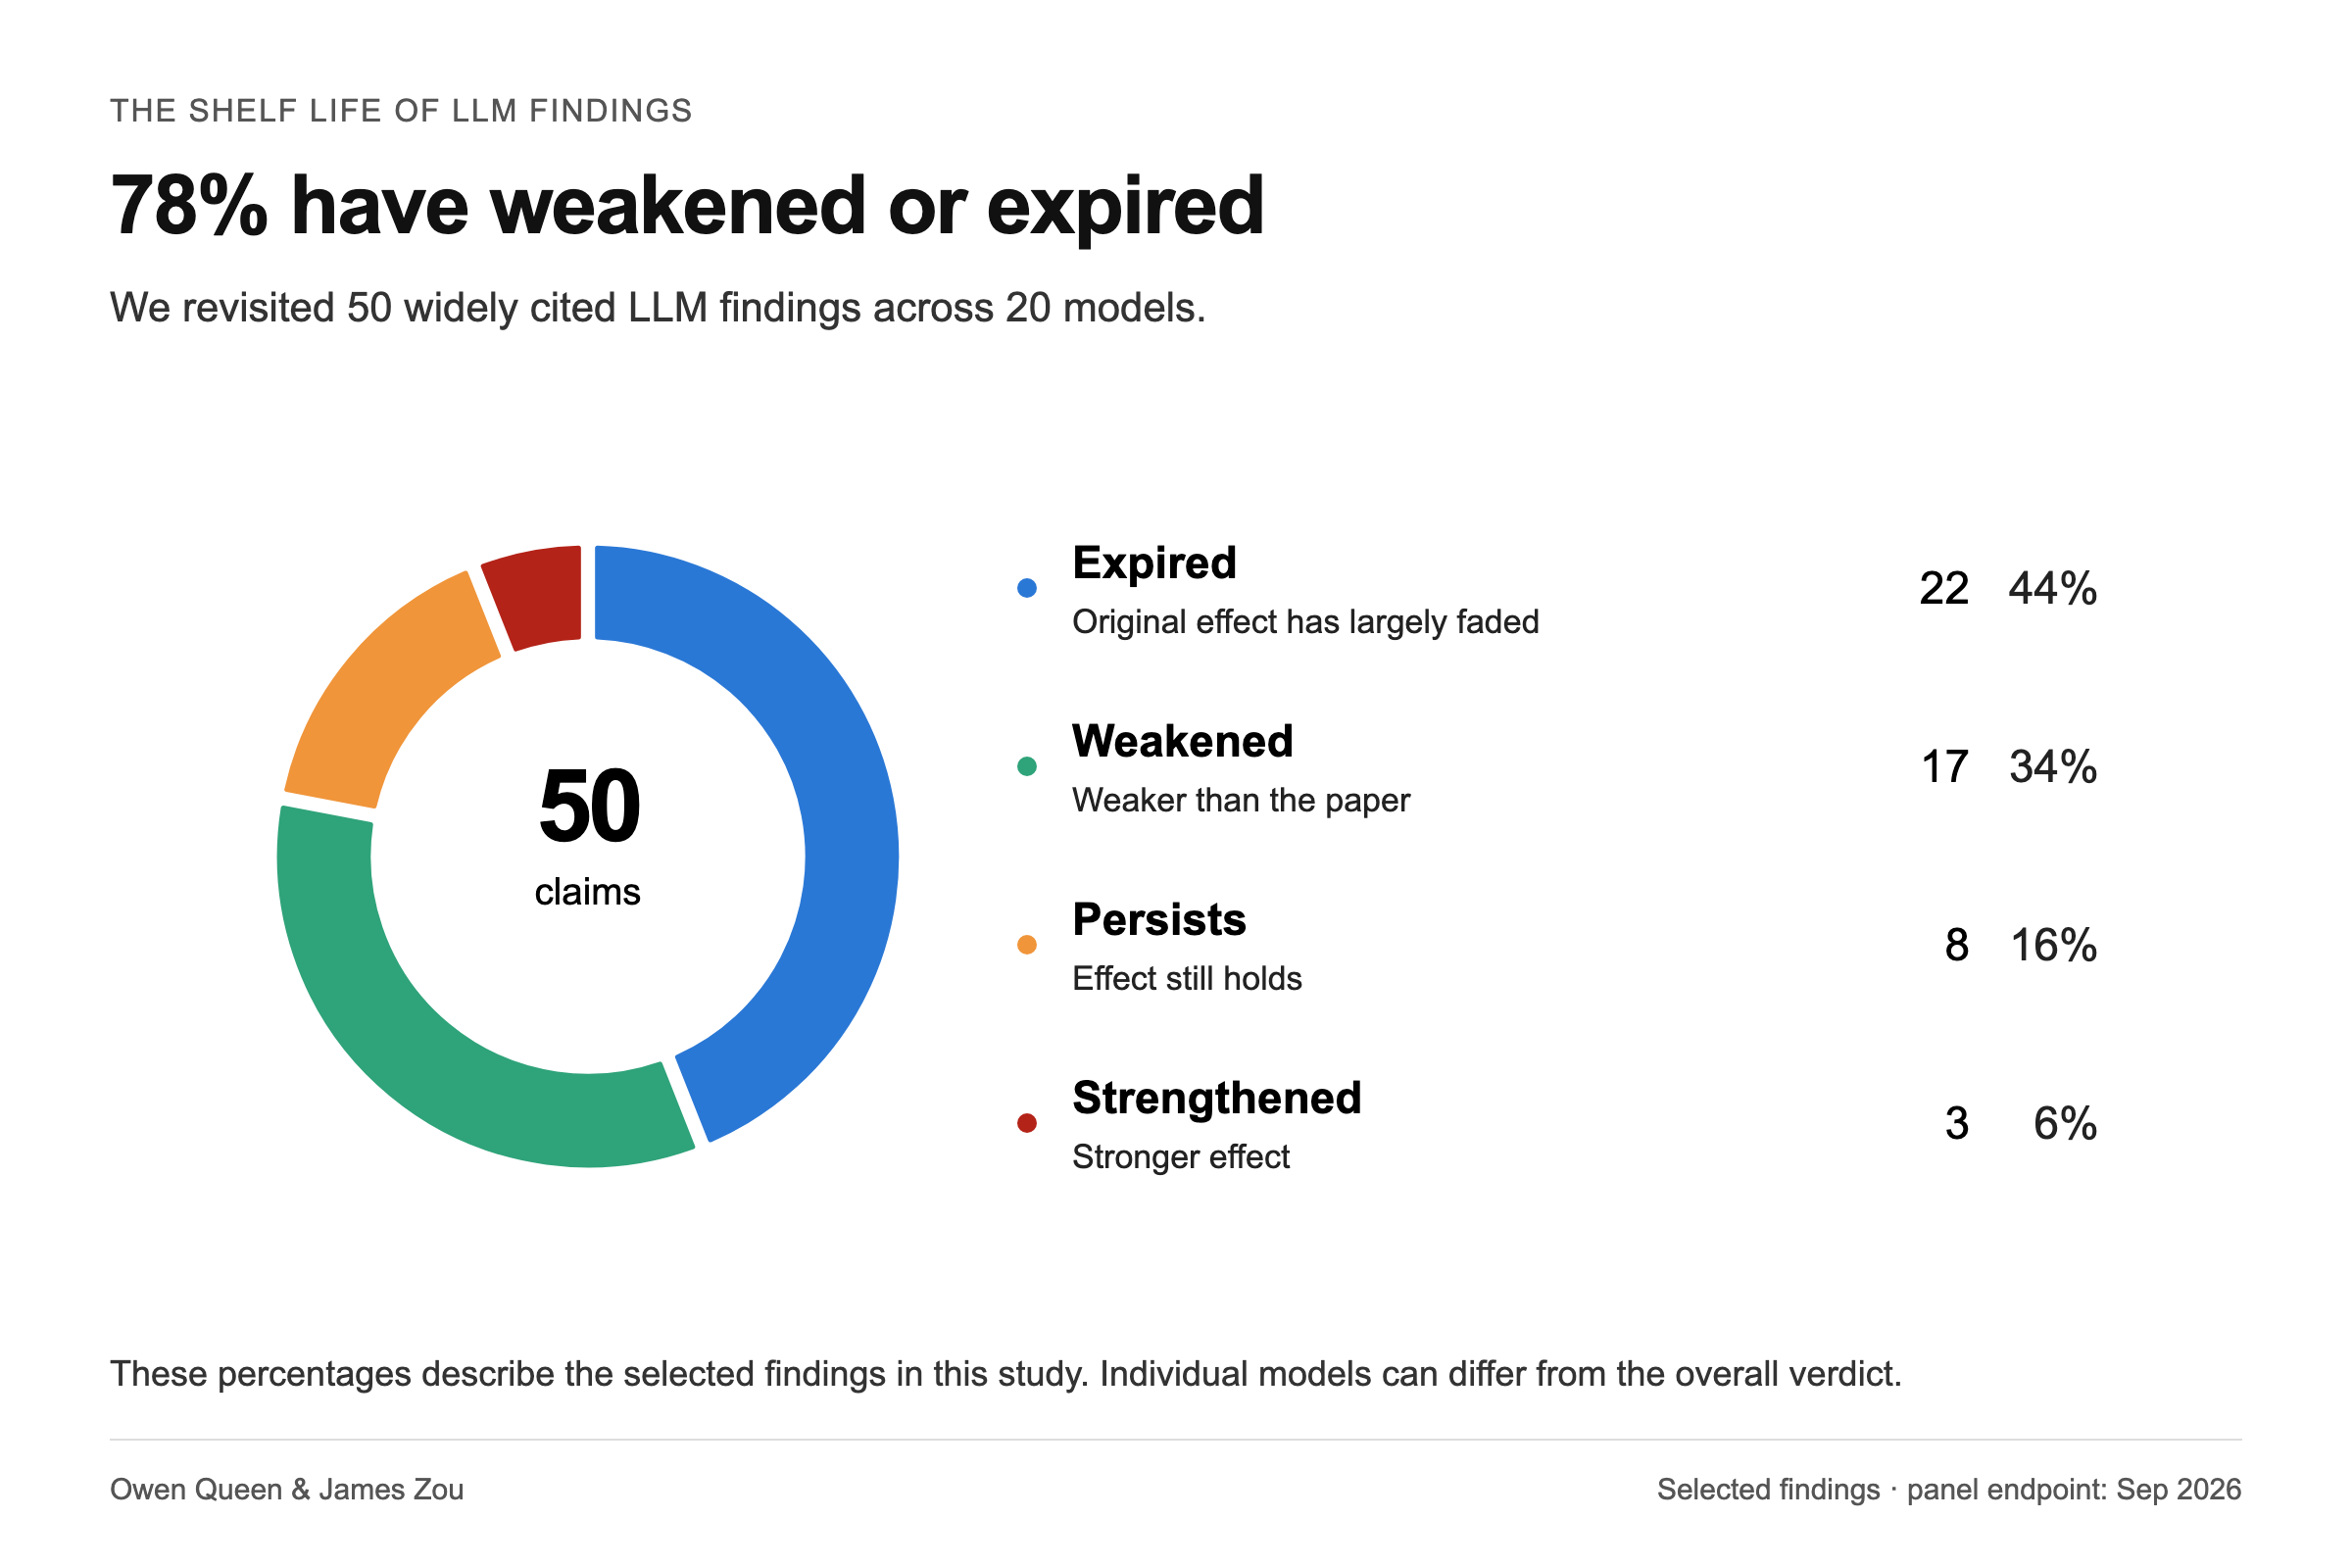
Image · Source originale
Des chercheurs ont revisité 50 constats publiés sur les LLM (sycophancy, jailbreaks, long contexte, biais culturels) avec 20 modèles sortis entre juillet 2024 et septembre 2026. Selon leur classification, 44 % des constats sont expirés, 34 % affaiblis, 16 % persistent et 6 % se renforcent. Cinq des neuf constats sur le raisonnement et six des onze sur la sycophancy et la tromperie sont expirés.
Traduit et résumé par IA à partir de l'article de zou-group.github.io ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Artificial Analysis v5 et le dilemme de ceux qui conçoivent les benchmarks28 octobre 2026
- Mesurer avant d'entraîner : modèles de décision typés, baseline classique et LLM génératif pour router une boîte mail multilingue23 octobre 2026
- Prédiction de benchmarks à partir de réponses en cache éparses et non appariées2 novembre 2026
- StudentBench : le tutorat par IA égale le tutorat humain pour les progrès au GRE23 septembre 2026
- OpenAI présente MentalHealthBench, un benchmark pour les conversations de santé mentaleOpenAI · 23 septembre 2026
- Best LLM for every budget : comparatif de modèles mis à jour quotidiennement24 septembre 2026