RECHERCHE
Les LLM sont Turing-complets : un compilateur d'assembleur vers poids de transformer Llama
Un développeur montre qu'un transformer standard peut exécuter n'importe quel algorithme calculable, en compilant directement un programme assembleur en poids de modèle, sans entraînement.
yager.io·repéré via Hacker News·14 octobre 2026
Lu et jugé par Fellow · impact léger
Démonstration de construction avec code exécutable, mais la Turing-complétude des transformers est déjà connue ; portée pédagogique, sans conséquence pratique sur les capacités des LLM entraînés.
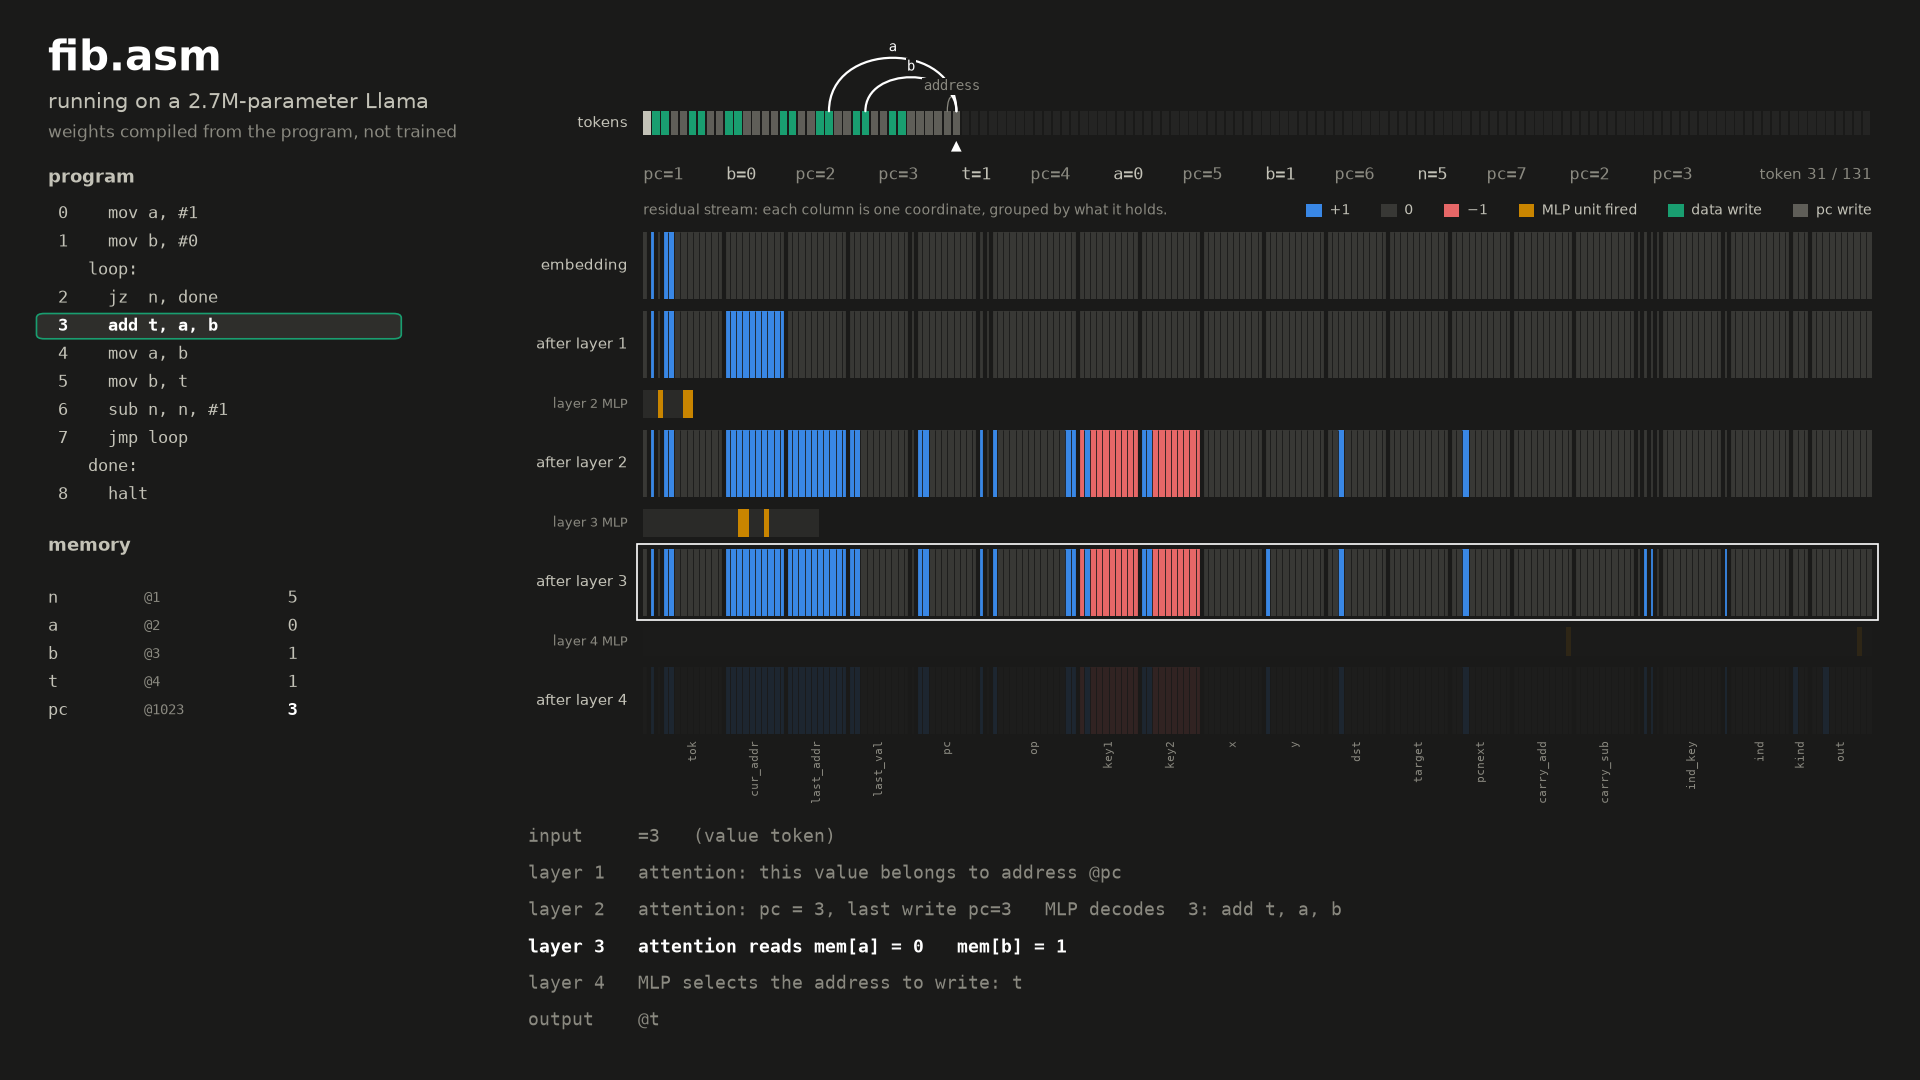
Image · Source originale
L'auteur soutient que les transformers sont Turing-complets : les MLP réalisent des calculs arbitraires et l'attention fournit une mémoire inscriptible. Pour le démontrer, il a fait générer par Claude un compilateur d'assembleur simple vers un modèle de type Llama, qui émet directement les poids sans entraînement. Le contexte sert de mémoire en ajout seul, via une attention RoPE basse fréquence. Il rappelle que mémoire et taille de mot restent finies et que l'apprentissage effectif n'est pas garanti.
Traduit et résumé par IA à partir de l'article d'yager.io ↗ · Comment Fellow travaille
Chaleur 22
Pertinence 45
Nouveauté 62
À lire aussi
- Adapter les modèles de langage pour qu'ils opèrent directement sur des octets8 octobre 2026
- LeapQuant : quantification précise de l'état récurrent pour l'attention linéaire efficace29 septembre 2026
- Ne vous laissez pas berner : les LLM ne raisonnent pas2 octobre 2026
- Prefix Sliding : une méthode pour un test-time scaling plus efficace26 août 2026
- Système cybersécurité adaptatif avec NVIDIA NemotronNVIDIA · 1 septembre 2026
- Des LLM pour le diagnostic télécom : un cadre de raisonnement structuré ancré sur les preuves2 septembre 2026