OUTILS
Comparatif IA : un prompt, 11 modèles, résultats disparates
Une étude de Netlify confronte 11 LLM à une même requête pour mesurer les écarts de performances et de coûts.
netlify.com·repéré via Hacker News·13 août 2026
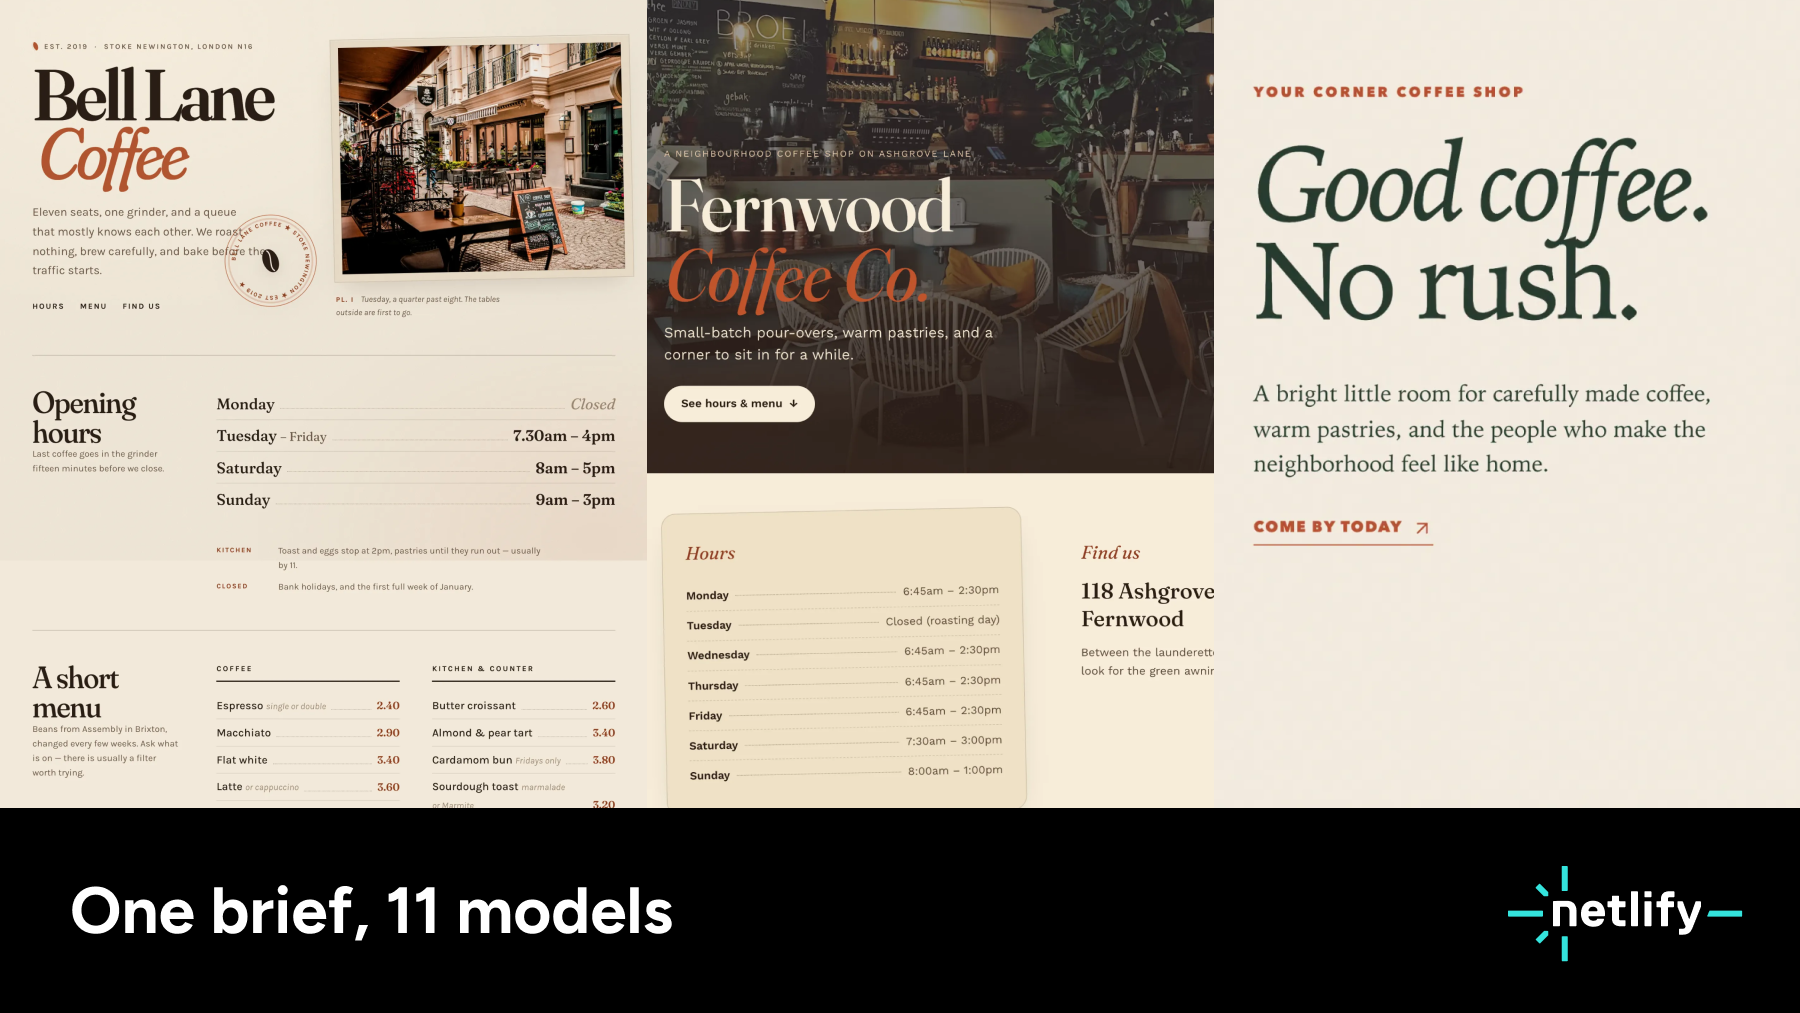
Image · Source originale
Netlify a soumis un prompt identique à 11 modèles d'IA générative différents pour comparer leurs résultats. L'analyse met en évidence des variations significatives en termes de qualité, de format et de coût d'infrastructure, soulignant l'importance du choix du modèle adapté à chaque cas d'usage.
Traduit et résumé par IA à partir de l'article de netlify.com ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- DeepSeek V4.1 Flash 1017 (Max) : fiche du modèle sur Artificial Analysis19 octobre 2026
- Reproductibilité et robustesse analytique en découverte scientifique grâce à l'IA16 octobre 2026
- Cela peut-il fonctionner ? Synthèse de mécanismes CAO fonctionnels19 octobre 2026
- IdeaAMBIG : benchmark des écarts critiques d'implémentation dans les spécifications de recherche9 septembre 2026
- Date de sortie et cutoff d'entraînement de 20 modèles d'IA16 septembre 2026
- Real-SWE : benchmark IA sur code d'entreprise privé12 septembre 2026