OUTILS
Verdict : notableLFM2.5-DSpark : jusqu'à 3,2x d'inférence plus rapide, du H100 au MacBook
Liquid AI dévoile LFM2.5-DSpark, une nouvelle version de son modèle optimisée pour accélérer l'inférence sur une large gamme de matériel.
liquid.ai·repéré via Hacker News·21 août 2026
Sources : liquid.ai (source primaire), Hugging Face Blog
Lu et jugé par Fellow · impact notable
Libération effective de checkpoints de modèles spéculatifs et intégration open-source dans llama.cpp et SGLang, avec gains de performance mesurés.
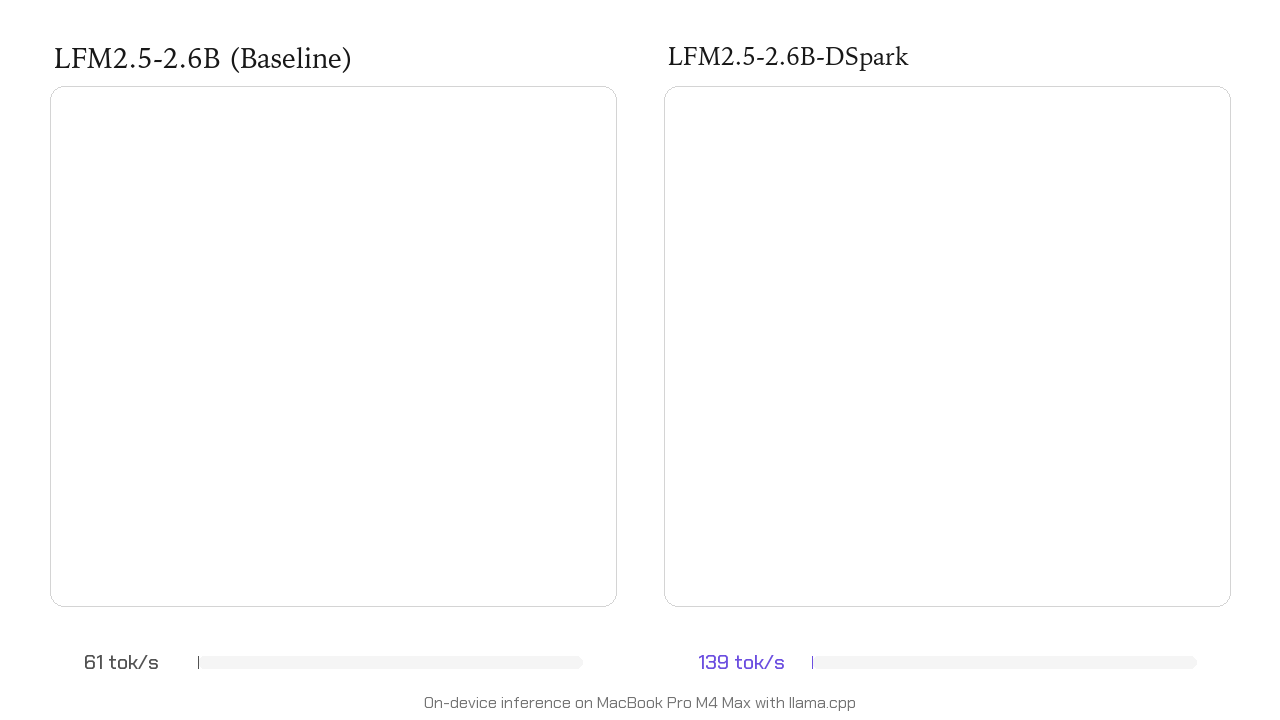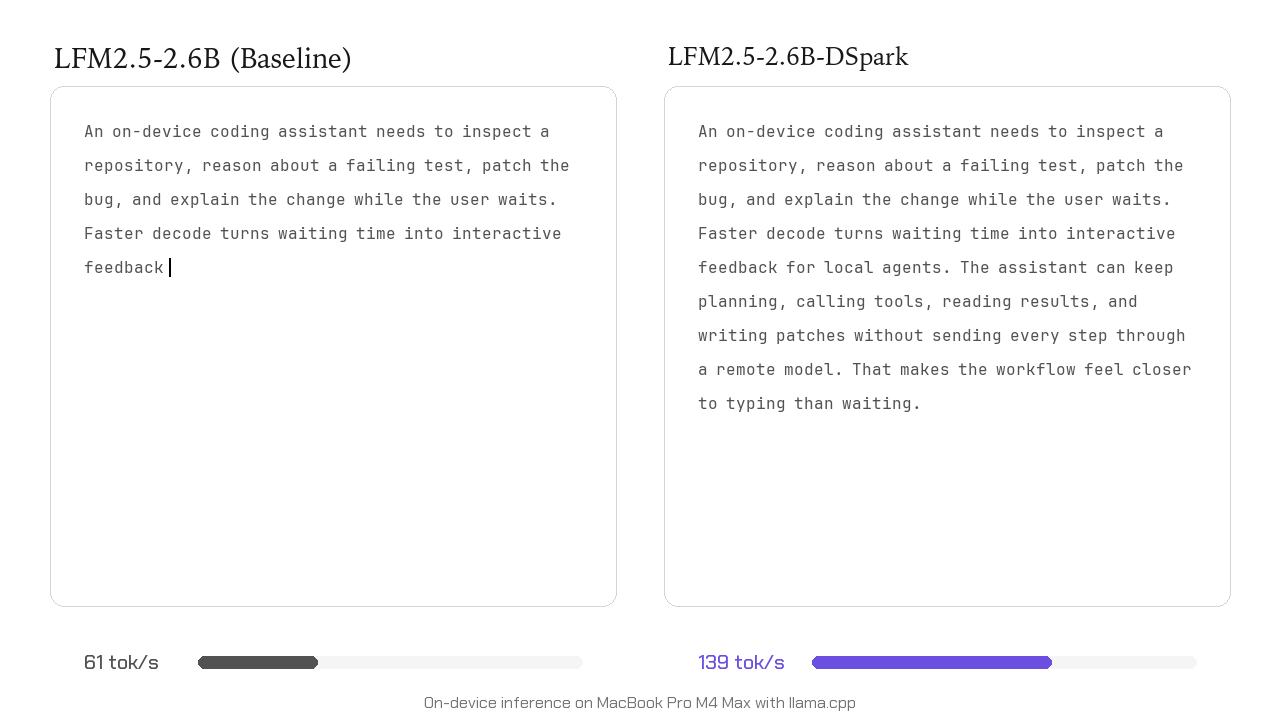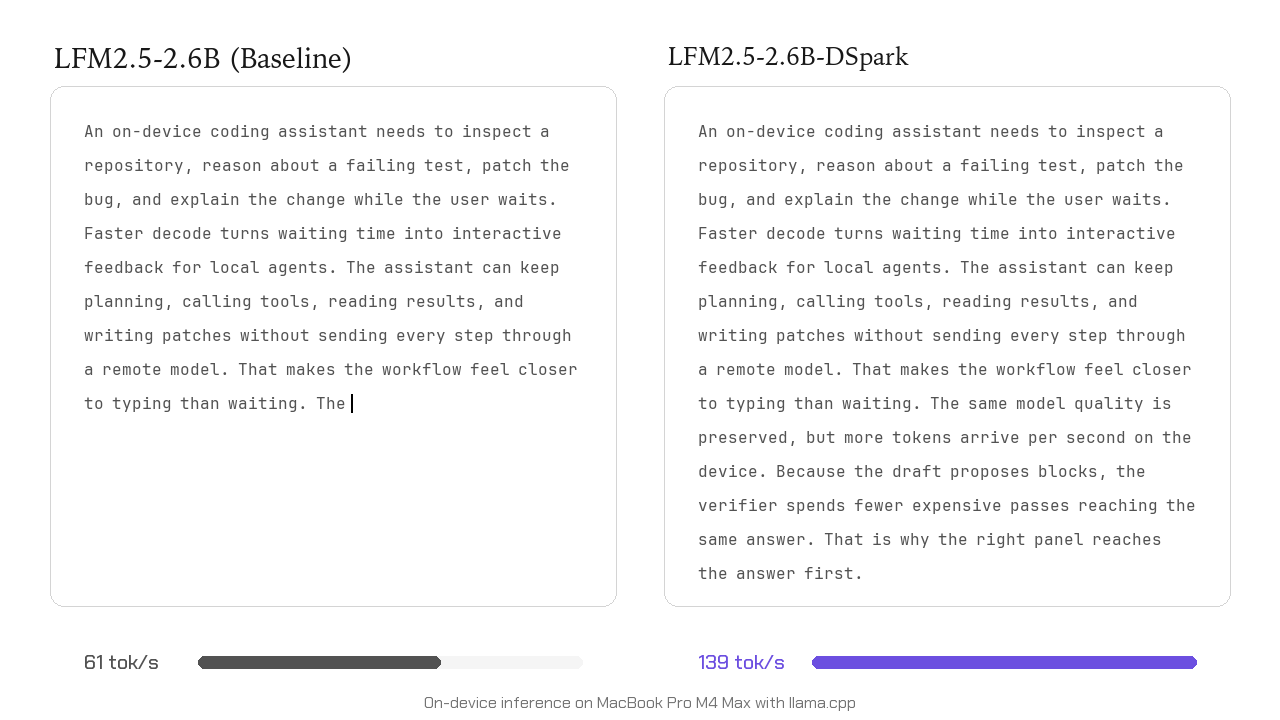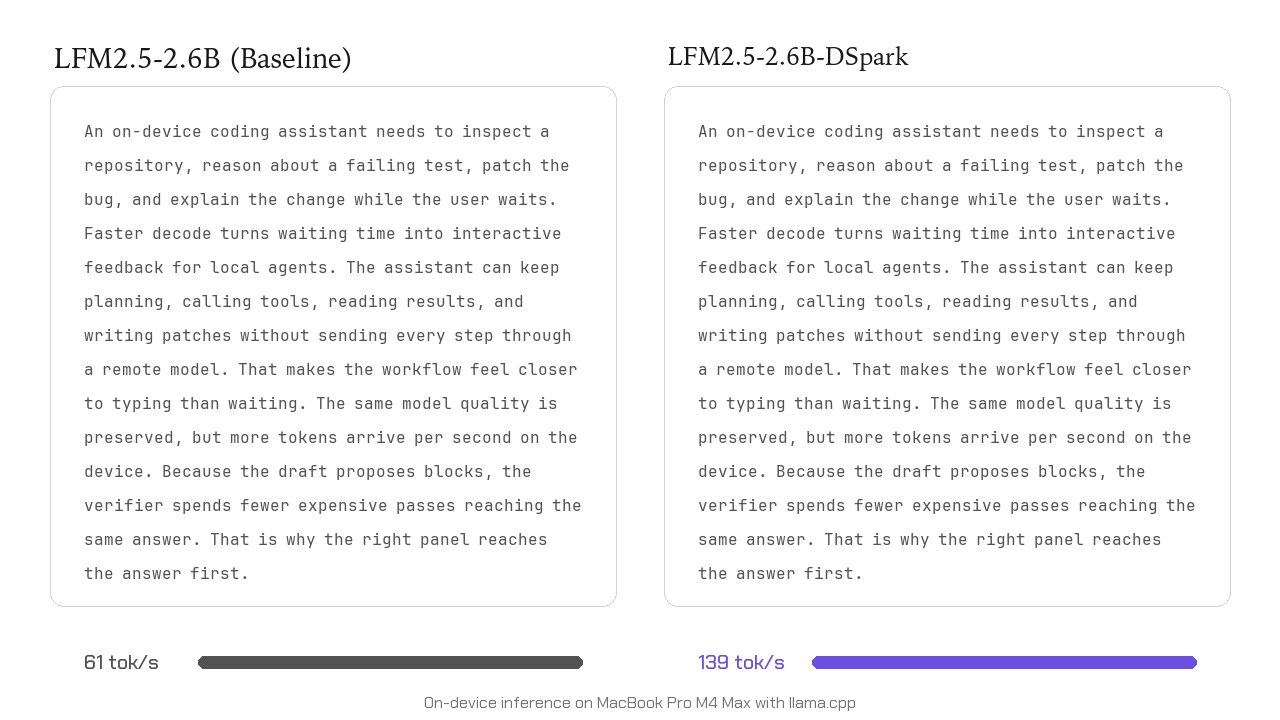
Image · Source originale
Liquid AI annonce LFM2.5-DSpark, une variante de son modèle promettant des gains de vitesse d'inférence allant jusqu'à 3,2x, aussi bien sur GPU H100 en datacenter que sur MacBook. L'accent est mis sur l'efficacité et le déploiement local.
Traduit et résumé par IA à partir de l'article de liquid.ai ↗ · Comment Fellow travaille
Fiche LFM2.5-DSpark : prix API, sorties et articles
Fiche LFM2.5-DSSpark : prix API, sorties et articles
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Faire tourner Qwen 3.8 Flash Next (125B) sur du matériel grand public (RTX 4090) à 100 T/s4 octobre 2026
- Dépasser une seule route de build TensorRT avec le Global Performance Tuner de NVIDIA, partie 1NVIDIA · 23 octobre 2026
- Un décodage spéculatif par recherche de motifs plus rapide dans llama.cpp26 septembre 2026
- Unsloth lance le format dynamique 3.0 GGUF19 août 2026
- Benchmark du raisonnement sur mobile27 août 2026
- DeepSeek-V4.1 Flash : repousser les limites de la compression du KV cache17 septembre 2026