Jie Tang (Z.ai) : la fin des paramètres et lois de post-training
Le CEO de Z.ai explique pourquoi le nombre de paramètres ne suffit plus et présente GLM 5.3.
Lu et jugé par Fellow · impact notable
Analyse technique argumentée d'un CEO de lab influent avec détails vérifiables sur GLM-5.3 (RL sur environnements longs, méthode de synthèse d'environnements).
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Fiche GLM-5.3 : prix API, sorties et articles
Développement
· Généré par GLM 4.7↓ LIRE LE DÉVELOPPEMENT · 2 MIN← MASQUER LE DÉVELOPPEMENT
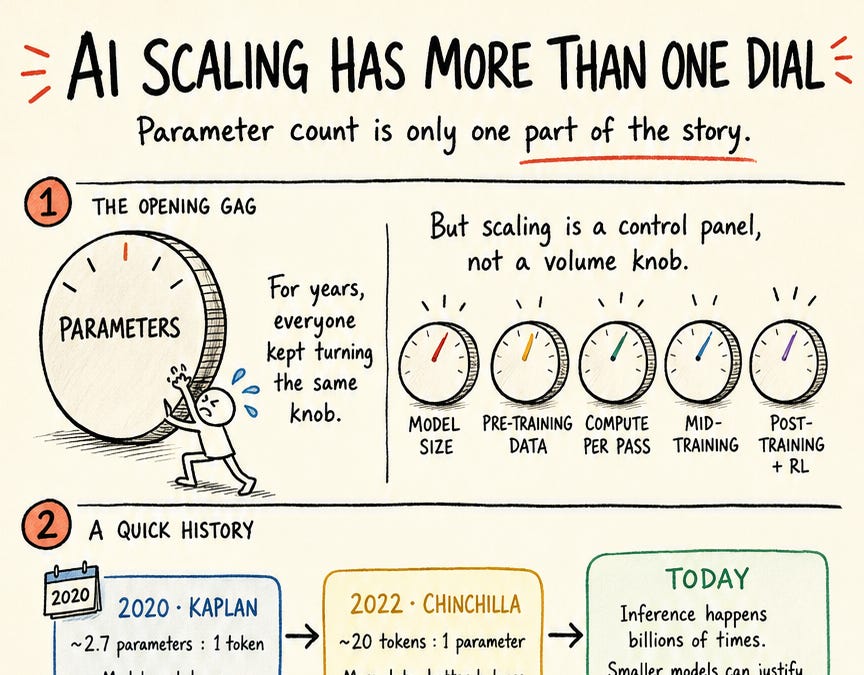
Le professeur Jie Tang, CEO de Z.ai, remet en cause l'obsession industrielle pour le seul nombre de paramètres, jugeant ce métrique insuffisant pour évaluer la capacité réelle des modèles dans le contexte actuel. Il avance que le volume de paramètres ne prend son sens que corrélé à trois autres variables critiques : le volume de données disponibles, l'allocation du budget de calcul et les conditions d'inférence, notamment l'utilisateur final. Cette position s'inscrit en rupture avec les hypothèses historiques des lois de mise à l'échelle de type Chinchilla, qui prévalaient lors de l'ère du pré-entraînement statique. Dans ce nouveau paradigme baptisé "Inference Inflection", la relation entre taille du modèle et tokens nécessaires n'est plus fixe mais dépendante des tâches, invalidant l'idée qu'un modèle plus grand est systématiquement supérieur pour tout type de raisonnement.
La distinction fondamentale établie par Jie Tang réside dans la séparation entre la mémorisation et le raisonnement. Si la mémorisation de connaissances bénéficie effectivement de l'ajout de paramètres, le raisonnement complexe tire son efficacité d'une augmentation des données de post-training et d'une profondeur effective accrue. L'introduction des "lois de post-training" suggère que les performances des modèles avancés comme GLM-5.3 dépendent moins de l'architecture de base que de la qualité de l'entraînement par renforcement (RL) appliqué sur des environnements à long terme. Pour GLM-5.3, les gains significatifs ne proviennent pas d'une expansion de la taille du modèle, mais d'un mois supplémentaire de RL focalisé sur des tâches mimant le travail d'ingénierie et de recherche réels, couvrant plusieurs jours de travail humain et nécessitant une gestion autonome de bout en bout.
Pour répondre aux exigences de ces environnements complexes, Z.ai a développé des pipelines permettant de synthétiser entièrement les environnements d'entraînement ainsi que les signaux de récompense. Des agents de recherche collectent des motifs de tâches à partir de travaux réels pour les transformer en environnements exécutables avec des dépendances multi-étapes et des états cachés. Un agent juge vérifie ensuite la solvabilité de chaque tâche. Cette méthode permet de créer des vérificateurs fiables sans accéder à la solution de référence, en utilisant les trajectoires du solveur pour détecter et fermer les raccourcis de récompense. L'accent est mis sur la capacité du modèle à maintenir des chaînes causales longues, dépassant vingt étapes d'inférence, une compétence critique pour des fonctions avancées comme la recherche de vulnérabilités logicielles qui ne relèvent pas de la simple récupération d'informations.
Jie Tang élargit finalement la discussion en identifiant cinq leviers de mise à l'échelle, délaissant la taille brute au profit de facteurs comme la parcimonie des modèles d'experts (MoE), introduisant une nouvelle notation XA-YB. L'implication technique est que passé un certain seuil de connaissances, l'augmentation des paramètres n'apporte plus de gain marginal pour les compétences de raisonnement avancées. L'industrie semble ainsi converger vers une optimisation de la recette de post-training, où la qualité des données, la sophistication de l'environnement de RL et l'efficacité de l'inférence deviennent les déterminants principaux de la performance des modèles, reléguant le simple comptage de paramètres au rang d'indicateur secondaire.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- BeNice! : combler l'écart inférence-mémoire des modèles bouclés grâce au KV-sharing22 octobre 2026
- Acceptation n'est pas vitesse : l'inflation de longueur dans le décodage spéculatif lossy sans entraînement16 octobre 2026
- LeapQuant : quantification précise de l'état récurrent pour l'attention linéaire efficace29 septembre 2026
- Motif-3, GLM-5.3, Hy4-preview et la nouvelle donne des licences8 septembre 2026
- GLM-5.3 : résultats des benchmarks Artificial Analysis19 août 2026
- Propriété d'une tablette assistée par 4 modèles IA23 août 2026