OPINION
Verdict : notable10% moins bon, 100x moins cher, 10000x plus rapide : la simulation prend le dessus
Depuis 2022, chaque étape du pipeline d'entraînement bascule progressivement de l'humain vers le modèle : signal de récompense, données, environnements RL.
Latent Space (Swyx)·22 août 2026
Lu et jugé par Fellow · impact notable
Propose une grille de lecture étayée et structurée de l'évolution du pipeline d'entraînement (données, reward, environnement) vers le synthétique.
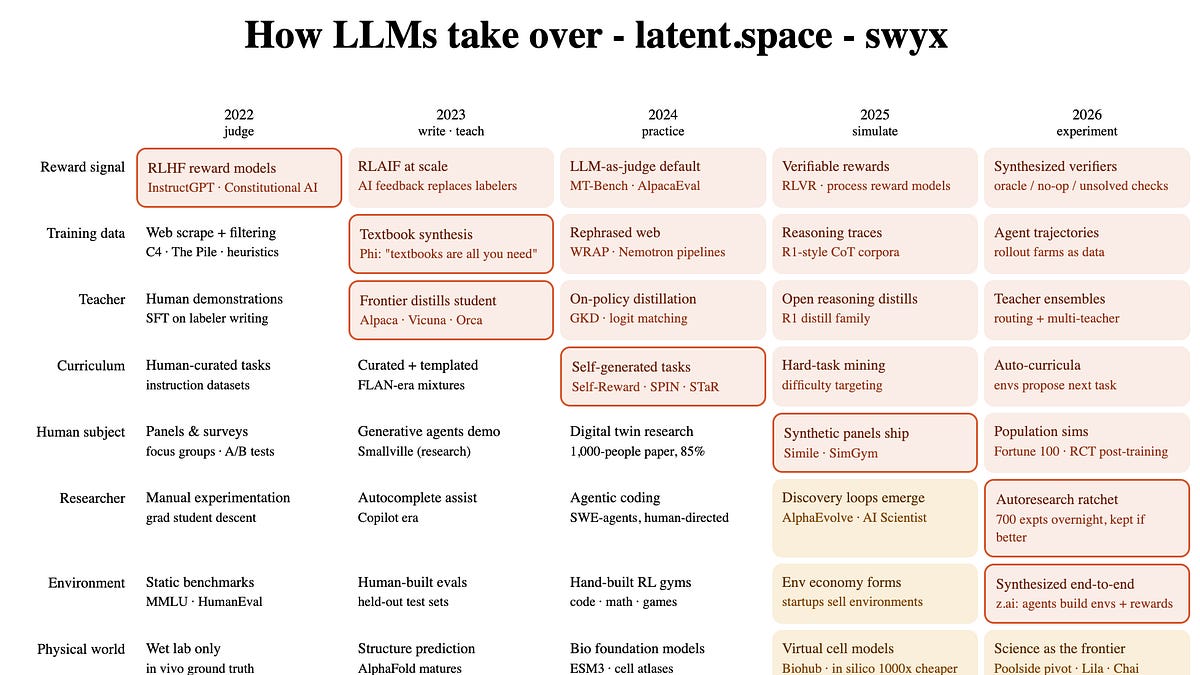
Image · Source originale
Latent Space propose une grille de lecture des tendances IA récentes (GLM de Z.ai, pivot Poolside, IA pour la science) : chaque année depuis 2022, une composante du pipeline d'entraînement des modèles passe du fait humain au fait synthétique. Cela commence avec le reward model (InstructGPT, Constitutional AI), puis s'étend aux données, aux rubriques d'évaluation et désormais aux environnements RL de bout en bout. Le résultat est une simulation de plus en plus ambitieuse de l'humain : moins précise, mais bien moins coûteuse et bien plus rapide.
Traduit et résumé par IA à partir de l'article de Latent Space (Swyx) ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- X-Reset : passer à l'échelle le RL centré-objet grâce à des resets cross-embodiment28 septembre 2026
- PrismaCoder : repousser les limites de l'intelligence de code multimodale ouverte via la synthèse de rubriques décomposées14 octobre 2026
- Entraîner un agent imaginatif : le framework Agentic Imagination (Agima)19 octobre 2026
- Vers des LLM « natifs des compétences » : l'entropie des compétences pour évaluer et entraîner le raisonnement long5 août 2026
- CARE-X : un VLM pour radiologie clinique aligné et assisté par outilsMicrosoft · 11 août 2026
- Sentinel-RL : externaliser le raisonnement topologique des agents LLM dans le SOC3 septembre 2026