OUTILS
Manuel RLHF : aligner et post-trainer les LLM
Nathan Lambert publie un ouvrage de référence sur le post-training, couvrant RLHF, rejet sampling et reward models.
Interconnects (Lambert)·Nathan Lambert·10 août 2026
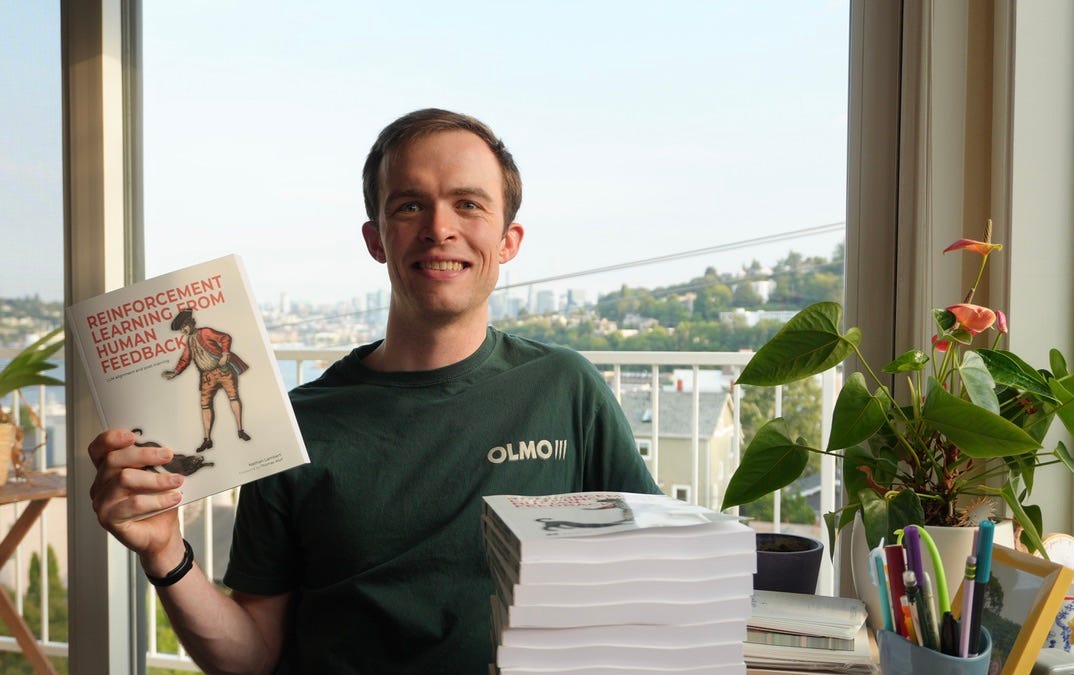
Image · Source originale
Nathan Lambert publie son ouvrage chez Manning, intitulé Reinforcement Learning from Human Feedback. Ce livre documente les méthodes de post-training et d'alignement des LLM, expliquant les techniques fondamentales comme le rejection sampling et les outcome reward models. L'auteur vise à clarifier les intuitions et l'histoire de ces processus techniques pour combler un manque de ressources pédagogiques.
Traduit et résumé par IA à partir de l'article d'Interconnects (Lambert) ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Couplages comportementaux : de leur formation à l'émergence de comportements dans les modèles de langage16 octobre 2026
- Hybrid Reasoning Agents : des agents alternant raisonnement latent et interaction textuelle13 octobre 2026
- Prédire la performance des agents de code post-entraînés à partir des modèles de base7 octobre 2026
- Sélectivité du refus : refuser un sous-ensemble, pas toutHugging Face · 8 septembre 2026
- Un paradigme d'ordre zéro pour l'alignement des préférences des LLM16 septembre 2026
- La dernière IA construite par des humains : vers une véritable auto-amélioration récursive10 septembre 2026