RECHERCHE
Verdict : notableLe progrès en pré-entraînement vient surtout des données
Une étude compare recettes de modèles et corpus de données de 2019 à 2025 pour isoler la source réelle des gains de performance en pré-entraînement.
Dwarkesh Patel·Dwarkesh Patel·8 septembre 2026
Lu et jugé par Fellow · impact notable
Une étude empirique quantifie (x3,2) le gain d'efficacité des données vs modèles sur 6 ans, avec protocole et résultats.
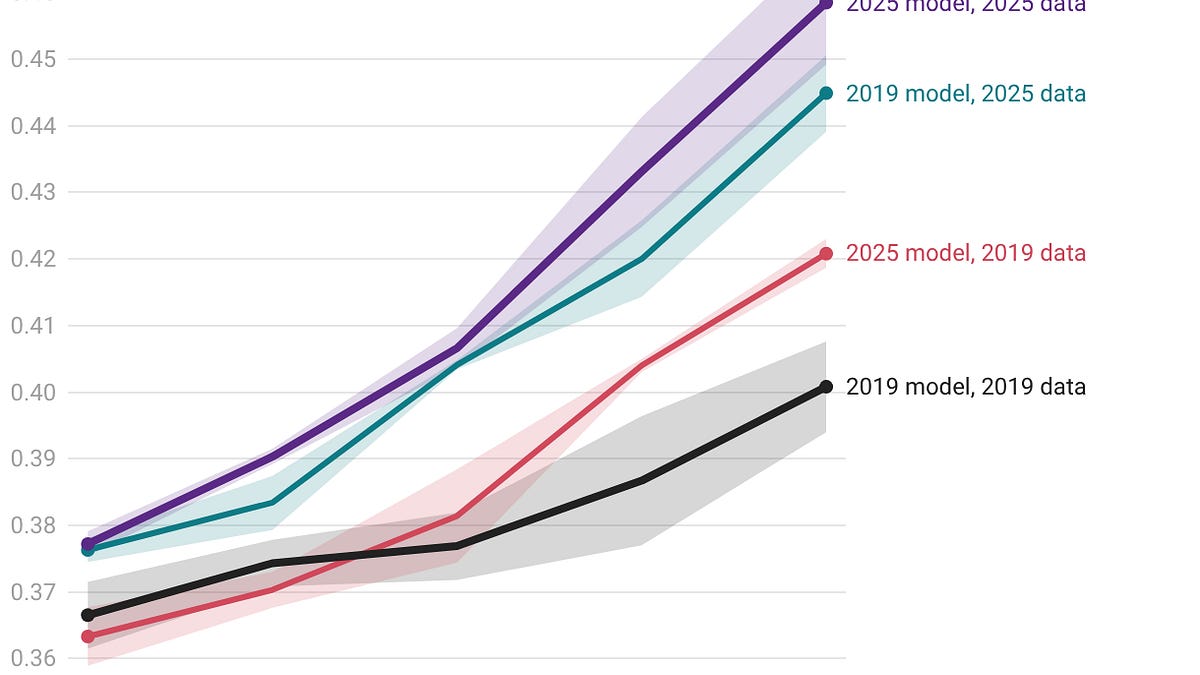
Image · Source originale
Des chercheurs entraînent des combinaisons de recettes de modèles et de corpus de données représentatifs de chaque année entre 2019 et 2025, à différentes échelles de calcul jusqu'à 1e19 FLOPs. L'évaluation se fait sur les capacités finales via OLMES plutôt que sur la perte d'entraînement, car les jeux de données diffèrent. Résultat : l'amélioration des données expliquerait une part largement supérieure des gains d'efficacité de calcul comparée aux avancées algorithmiques sur les modèles.
Traduit et résumé par IA à partir de l'article de Dwarkesh Patel ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Bottling : les agents LLM peuvent-ils transformer leurs capacités en artefacts économiques et scalables ?6 octobre 2026
- Kimi K3.1 obtient 55 sur Artificial Analysis et se place sur la ligne de Pareto23 octobre 2026
- The Epoch Brief – 23 octobre 2026 : l'IA peut-elle automatiser le travail d'Epoch ?23 octobre 2026
- 44 % sur ARC-AGI-1 pour 67 centimes de dollar1 septembre 2026
- EarlyEval : réduire le coût de l'évaluation des agents grâce à la prédiction précoce des résultats2 septembre 2026
- LLM : intelligence versus coût, un arbitrage à repenser2 septembre 2026