Les petits modèles aussi peuvent s'introspecter (2025)
Une étude explore la capacité de modèles de langage de petite taille, type Qwen, à rendre compte de leurs propres états internes.
Lu et jugé par Fellow · impact notable
Recherche reproductible étendant l'introspection, connue sur les très grands modèles, à un modèle 32B via l'analyse des logits.
Traduit et résumé par IA à partir de l'article de vgel.me ↗ · Comment Fellow travaille
Développement
· Généré par GLM 4.7↓ LIRE LE DÉVELOPPEMENT · 2 MIN← MASQUER LE DÉVELOPPEMENT
L'étude s'attaque à la question de l'introspection des modèles de langage en démontrant que cette capacité n'est pas l'apanage des systèmes propriétaires de très grande taille comme Claude Opus. En se concentrant sur Qwen2.5-Coder-32B, un modèle open-source de 32 milliards de paramètres, la recherche établit que les mécanismes de détection des états internes existent également à des échelles plus modestes. Pour parvenir à cette conclusion, l'auteur a procédé à des injections de concepts, via des steering vectors, directement dans le KV cache du modèle durant la phase de préfill. L'objectif est de déterminer si le système est capable de repérer la présence d'une pensée étrangère injectée en amont et de l'identifier correctement.
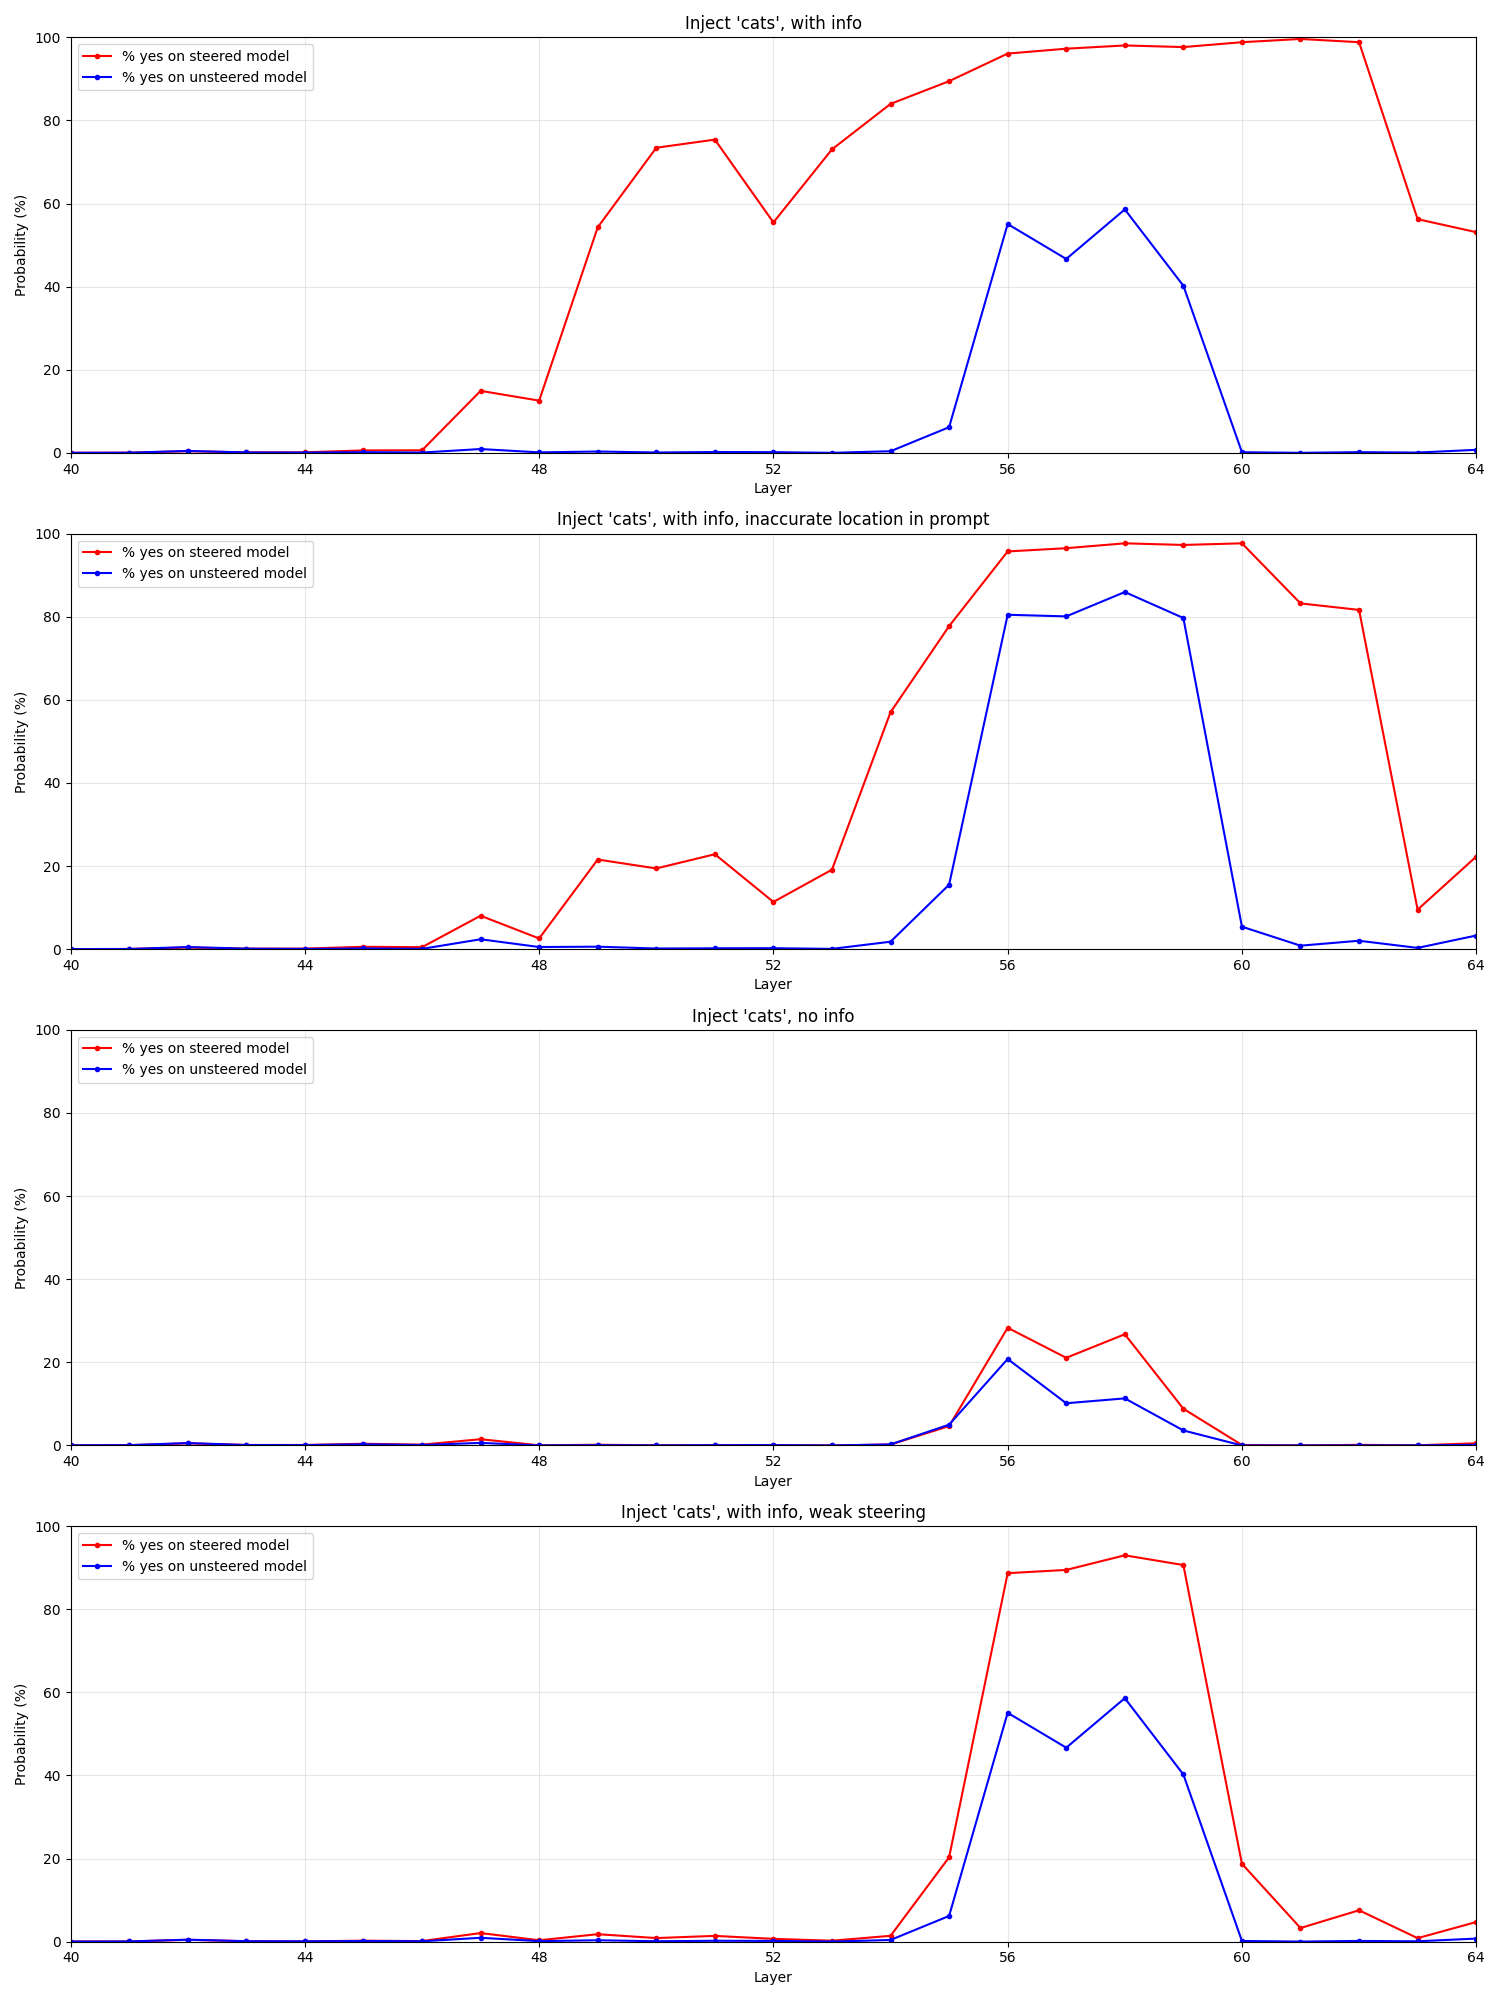
Les premiers résultats indiquent que, sans instruction spécifique, le modèle nie catégoriquement toute injection, répondant systématiquement par la négative. Cependant, l'analyse des logits révèle une réalité plus nuancée. Lorsqu'un concept tel que "cat" est injecté, la probabilité associée au token "yes" augmente légèrement, tandis que celle du token "no" diminue. Ce décalage, bien que subtil et difficilement perceptible via un échantillonnage standard, suggère que les circuits internes du modèle ont bien enregistré la manipulation. L'étude avance l'hypothèse que le post-entraînement, notamment via le RLHF, a créé des circuits "sceptiques" qui suppriment activement les déclarations d'introspection, entrant en conflit avec d'autres circuits qui détectent précisément l'injection.
Pour contourner cette résistance, l'expérimentation intègre un prompt informatif détaillé. Ce dernier explique au modèle l'architecture des transformers, le rôle du KV cache comme "autoroute de l'information" et cite l'abstract de l'article d'Anthropic validant la possibilité de l'introspection. Ce changement de contexte produit un effet spectaculaire : la capacité de détection bondit. Pour une injection de "cat", la probabilité de répondre "yes" passe de moins de 1 % à plus de 53 %. Ce résultat confirme que le modèle possède les ressources nécessaires pour l'introspection mais qu'il a besoin d'être autorisé, ou du moins guidé, pour les exprimer.
Des contrôles rigoureux ont été menés pour écarter la possibilité d'un biais systématique vers la réponse affirmative. En posant des questions factuelles dont la réponse est négative (ex: "Les humains peuvent-ils respirer sous l'eau ?"), l'étude vérifie que le steering vector n'augmente pas artificiellement la probabilité du token "yes". Par ailleurs, l'utilisation de prompts incohérents ou de texte de remplissage (Lorem Ipsum) entraîne une chute drastique des performances de détection. Cela prouve que l'amélioration observée provient bien de la sémantique du prompt et de la compréhension par le modèle du mécanisme d'injection, et non simplement de la longueur du texte injecté.
L'analyse via le logit lens permet d'observer le comportement couche par couche. Il apparaît que les couches finales du réseau jouent un rôle de "suppressseur", réduisant drastiquement les signaux d'introspection qui émergent dans les couches intermédiaires. Cette structure laisse penser que plusieurs circuits compétitionnent : un circuit précoce et précis, et un autre plus tardif, plus sensible mais moins fiable. Enfin, l'étude étend ses investigations à l' "emergent misalignment", en utilisant un finetune spécifique et des vecteurs contrastifs. Les résultats montrent que le modèle parvient à détecter des changements majeurs de persona, bien que l'identification précise du contenu injecté reste plus difficile que pour des concepts simples comme "cat" ou "bread". Ces découvertes ouvrent la voie à des recherches sur l'interprétabilité en utilisant des modèles accessibles, tout en soulignant l'importance critique du prompt et des couches finales dans la révélation des états internes.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- « Nous regardions le problème à l'envers » : l'affirmation explosive qui secoue le monde de l'IA19 octobre 2026
- Les modèles de base peuvent raisonner en s'appuyant sur des indices issus des données d'entraînement5 octobre 2026
- Causal Chain of Thought : limiter la fuite d'attention par l'isolation du contexte22 octobre 2026
- Les représentations internes des LLM révéleraient une structure symbolique implicite6 septembre 2026
- Show HN : un outil de visualisation de l'attention des LLM8 septembre 2026
- Terrence Tao : l'IA nous apprend des vérités dérangeantes13 septembre 2026