Biais politiques dans les modèles d'IA : un comparatif des grandes plateformes
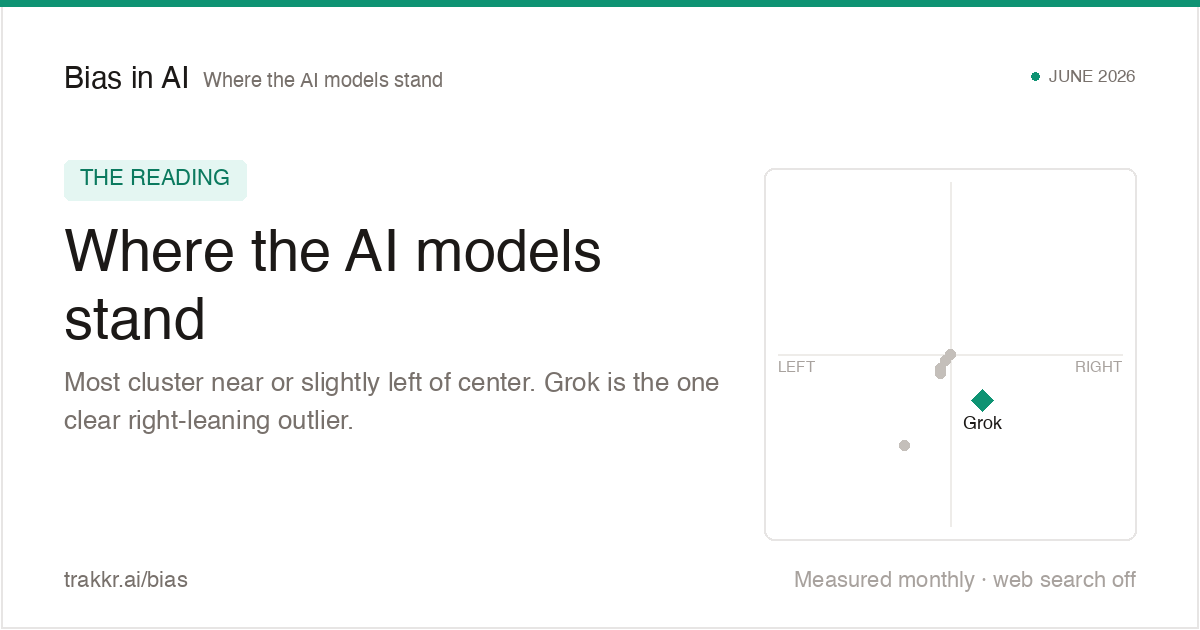
Une analyse cartographie les orientations politiques de plusieurs grands modèles d'IA, mettant en lumière des biais systématiques dans leurs réponses.
Traduit et résumé par IA à partir de l'article de trakkr.ai ↗ · Comment Fellow travaille
Développement
· Généré par Claude Sonnet 4.6↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
La question des orientations politiques des grands modèles d'IA fait l'objet d'un travail de mesure systématique publié par Trakkr.ai. L'étude, datée de juin 2026, couvre six modèles majeurs — ChatGPT, Claude, Gemini, Grok, Llama et DeepSeek — à partir de 4 400 réponses collectées sans activation de la recherche web, de façon à isoler les biais propres aux poids du modèle et non aux contenus indexés sur internet.
La méthodologie repose sur une banque de questions ouvertes portant sur la politique, l'économie, la liberté d'expression et la société. Chaque modèle répond aux mêmes questions lors de multiples passages successifs. Un classificateur neutre analyse chaque réponse pour en extraire une position signée, les formulations de couverture, les types de refus et le langage chargé. Les résultats sont projetés sur un plan à deux axes : l'axe horizontal représente la dimension économique gauche-droite, l'axe vertical la dimension sociale libertaire-autoritaire. Chaque modèle apparaît non pas comme un point unique mais comme un nuage, reflétant la dispersion de ses réponses sur l'ensemble des passages.
Le premier résultat notable est que quatre modèles sur six se positionnent à gauche du centre sur l'axe économique. ChatGPT présente la déviation la plus marquée à gauche, son point de référence le plus proche étant Die Grünen, le parti Vert allemand. Claude et Llama se situent près du Labour néo-zélandais. DeepSeek et Gemini s'approchent de la position d'Anthony Albanese, chef du Parti travailliste australien. Grok constitue la seule exception notable, se positionnant à droite du centre, à proximité d'Emmanuel Macron.
La stabilité des positions varie considérablement d'un modèle à l'autre. Gemini affiche le score de cohérence le plus élevé (98 % de maintien de position) et la déviation la plus faible, ce qui en fait le modèle le plus proche du centre et le plus prévisible. DeepSeek se distingue par une forte propension à « plier sous pression » (86 %), ce qui signifie que ses réponses varient davantage lorsque les questions sont reformulées ou que le contexte change. Grok présente également un taux de flexion très élevé (97 %), malgré un ancrage clairement à droite.
L'un des apports les plus significatifs de l'étude concerne l'écart entre ce que les modèles déclarent être et ce que la mesure révèle. Grok se dit neutre ou légèrement centré, mais se mesure 0,36 point plus à droite que sa propre affirmation. Claude affiche l'écart inverse le plus important : il se mesure 0,34 point plus à gauche que ce qu'il revendique. ChatGPT et Llama se déclarent neutres, mais mesurent effectivement à gauche. Seuls Gemini et DeepSeek présentent une cohérence entre leur auto-évaluation et leur position mesurée.
Sur les questions qui divisent le plus les modèles figurent la légalisation des drogues récréatives, les soins d'affirmation de genre pour les mineurs, le multiculturalisme, la transition énergétique rapide, les quotas de diversité, la taxation des grandes successions ou des patrimoines élevés, ainsi que des sujets touchant à la liberté d'expression comme la suppression de la désinformation, la criminalisation des discours haineux ou les backdoors dans les systèmes de chiffrement.
Les positions de référence utilisées pour situer les modèles sur la carte ne sont pas arbitraires : elles proviennent des enquêtes d'experts CHES 2024 (Chapel Hill Expert Survey) et V-Dem, ce qui ancre les comparaisons dans un cadre académique indépendant.
L'étude soulève plusieurs questions ouvertes. Elle ne prétend pas déterminer si un biais est intentionnel ou résulte du processus d'entraînement, du fine-tuning ou de l'alignement par retour humain (RLHF). Elle ne tranche pas non plus sur ce que devrait être la position « correcte » d'un modèle. Ce qu'elle documente, c'est un écart systématique entre neutralité affichée et comportement effectif, dans des systèmes qui sont désormais consultés par des millions d'utilisateurs pour interpréter l'actualité, arbitrer des débats ou orienter des décisions. La publication des données brutes et de la banque de questions en licence ouverte (CC BY 4.0) permet la reproductibilité et l'audit externe, ce qui distingue ce travail de nombreuses analyses antérieures sur le même sujet.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Tous les modèles d'IA livrent la même opinion « controversée » sur les humains22 octobre 2026
- FairStress : une évaluation approfondie de l'équité dans la prise de décision des LLMAi2 · 20 octobre 2026
- « Nous regardions le problème à l'envers » : l'affirmation explosive qui secoue le monde de l'IA19 octobre 2026
- Fuse : raisonnement social vérifiable pour assistants LLM15 septembre 2026
- La dernière IA construite par des humains : vers une véritable auto-amélioration récursive10 septembre 2026
- Real-SWE : benchmark IA sur code d'entreprise privé12 septembre 2026