Un juge estime que les scripts de la « bibliothèque fantôme » de Nvidia n'ont d'autre usage que la contrefaçon
Un tribunal américain statue que les outils d'Nvidia pour constituer son corpus d'entraînement IA étaient conçus exclusivement pour violer le droit d'auteur.
Traduit et résumé par IA à partir de l'article de torrentfreak.com ↗ · Comment Fellow travaille
Développement
· Généré par IA↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
Le tribunal fédéral du district nord de Californie a refusé cette semaine de rejeter l'essentiel de la plainte déposée contre Nvidia par plusieurs auteurs, dont Abdi Nazemian, dans le cadre d'un recours collectif initié début 2024. La décision du juge Jon Tigar marque une étape notable dans la jurisprudence émergente autour de l'entraînement des LLM sur des données protégées par le droit d'auteur.
L'affaire porte sur les NeMo Megatron models développés par Nvidia, entraînés notamment à partir du dataset Books3, lui-même inclus dans The Pile. Books3 aurait été constitué à partir d'œuvres piratées hébergées sur Bibliotik, un site de distribution illicite de livres. Les plaignants ont également mis en lumière des échanges entre Nvidia et Anna's Archive, une bibliothèque fantôme (shadow library) agrégant des millions d'ouvrages piratés, au sujet d'un accès à haut débit à ses collections.
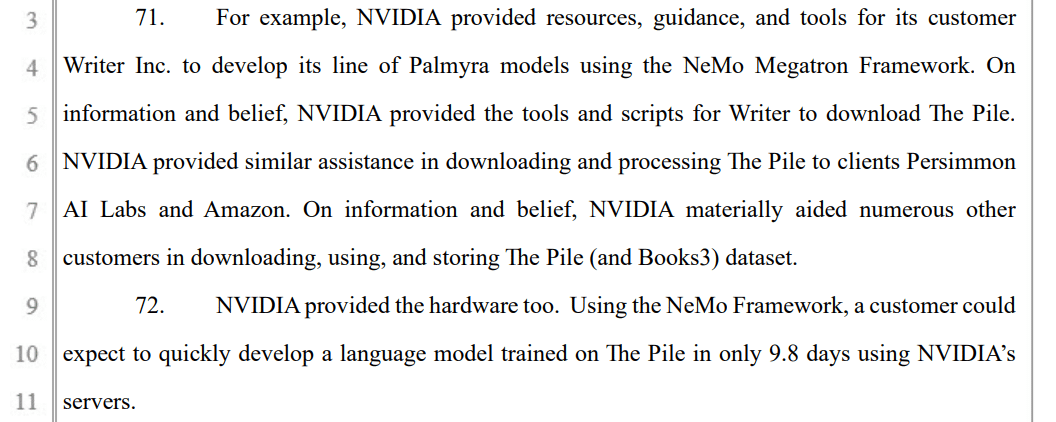
Le cœur de la décision concerne la notion de contributory infringement, soit la responsabilité indirecte pour avoir facilité une violation du droit d'auteur commise par des tiers. Nvidia avait distribué à ses clients professionnels des scripts permettant de télécharger et prétraiter automatiquement The Pile. La société arguait que le NeMo Megatron Framework dans son ensemble dispose d'usages légitimes substantiels, et que l'arrêt récent de la Cour suprême Cox v. Sony imposait désormais de démontrer une « incitation active par des actes spécifiques » pour retenir une telle responsabilité.
Le juge Tigar a écarté ce raisonnement. Plutôt que d'examiner le framework dans sa globalité, il a ciblé précisément les scripts en question, concluant qu'ils « n'ont d'autre finalité que d'accélérer le processus d'infraction », à la différence d'un enregistreur vidéo numérique ou d'un fournisseur d'accès à Internet. Cette distinction est juridiquement significative : elle contourne la doctrine Sony, qui protège les technologies à usage mixte, pour se concentrer sur des outils dont la conception ne servirait qu'à violer le droit d'auteur. Il s'agirait de la première application du standard Cox à un litige portant sur l'entraînement de modèles d'IA, et le résultat n'est pas favorable à Nvidia.
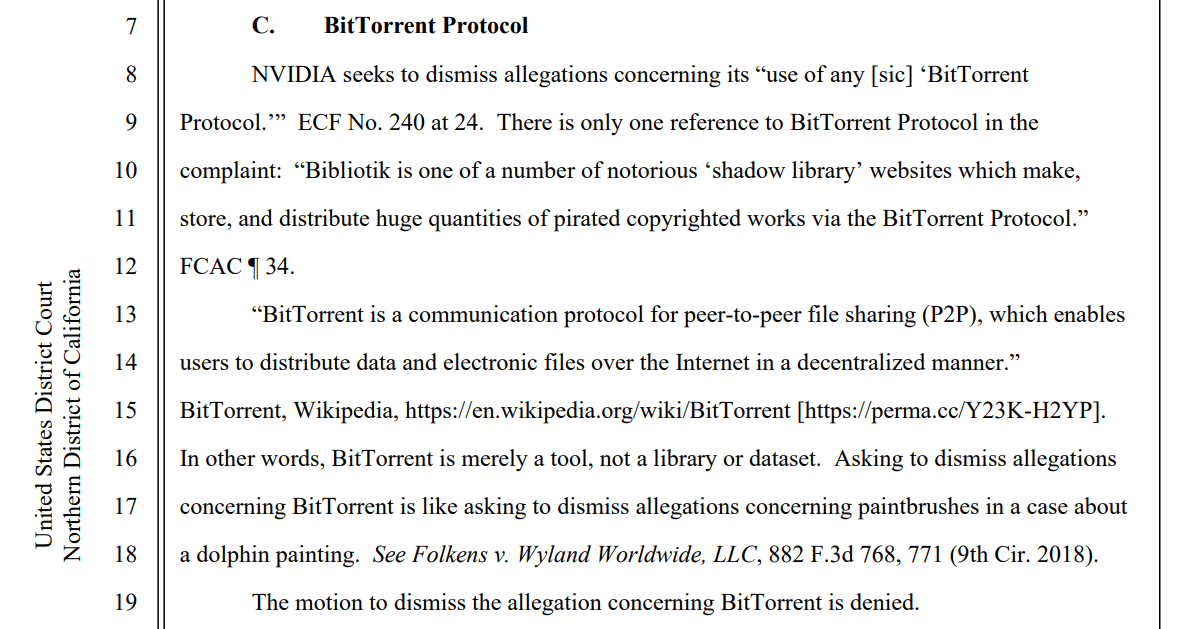
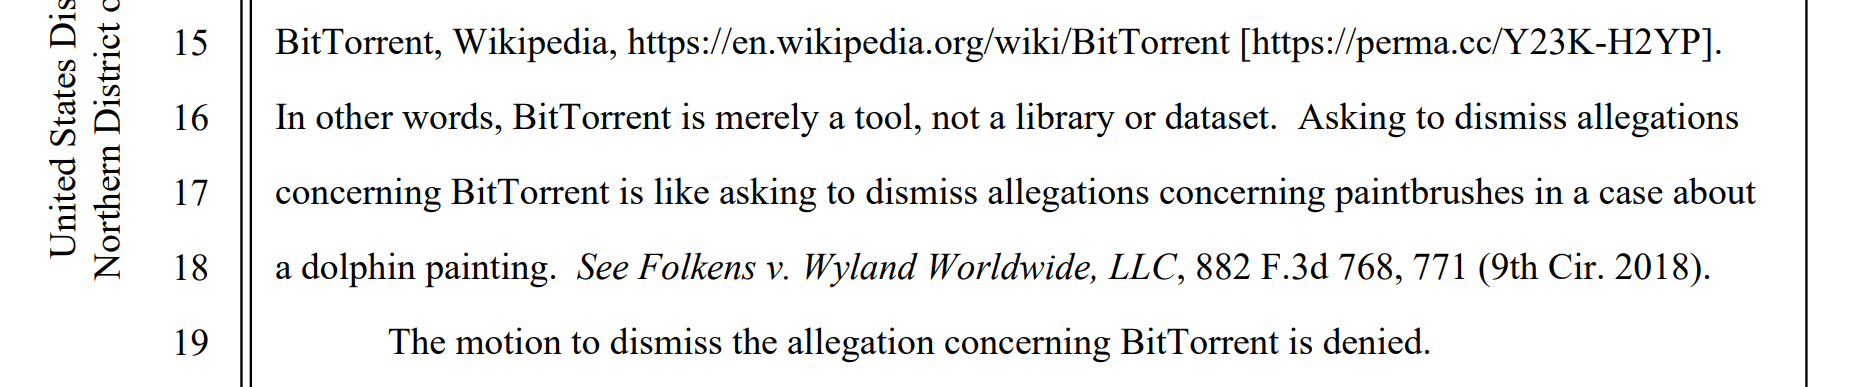
Sur la question du protocole BitTorrent, Nvidia avait demandé la suppression de toute référence dans la plainte, visiblement soucieuse d'éviter le précédent créé dans le litige parallèle contre Meta, où le seeding via BitTorrent avait directement engagé la responsabilité de la société. Le juge a refusé, rappelant que « BitTorrent est simplement un outil, pas une bibliothèque ou un dataset », et comparant la demande à celle de « retirer les références aux pinceaux dans une affaire sur un dauphin peint » — allusion au contentieux Folkens v. Wyland Worldwide. La formulation illustre la friabilité des arguments procéduraux avancés par Nvidia sur ce point.
Nvidia a néanmoins obtenu un succès partiel : la claim de vicarious copyright infringement a été rejetée, le tribunal estimant que les auteurs n'avaient pas suffisamment établi que Nvidia disposait d'un droit de contrôle sur les contrevenants directs ni d'un intérêt financier direct dans les infractions. Les plaignants ont 21 jours pour corriger ces insuffisances et redéposer.
Cette décision s'inscrit dans un contexte de multiplication des actions judiciaires contre les grandes entreprises technologiques pour constitution illicite de corpus d'entraînement. Meta fait face à des litiges similaires impliquant Books3 et des allégations de seeding BitTorrent, et de grands éditeurs viennent de déposer une nouvelle plainte contre Meta et Mark Zuckerberg. La question de savoir si le fair use peut couvrir l'utilisation à grande échelle d'œuvres protégées pour entraîner des LLM reste entière et sera vraisemblablement tranchée en appel, voire à nouveau devant la Cour suprême. Pour l'heure, la phase de discovery dans l'affaire Nvidia s'ouvre sur des bases procédurales solides pour les plaignants.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Pourquoi le langage généré par l'IA est-il si difficile à comprendre ?24 octobre 2026
- Comment concevoir un harness d'IA pour le développement de jeux vidéo13 octobre 2026
- Prédire la performance des agents de code post-entraînés à partir des modèles de base7 octobre 2026
- DeepSeek v4.1 Flash devient le meilleur modèle de hacking selon Enclave16 septembre 2026
- Débat sur la proximité de l'auto-amélioration récursive11 septembre 2026
- DeepSeek dévoile une collection Hugging Face pour DeepSeek-V4DeepSeek · 10 septembre 2026