Anthropic dévoile Claude Fable 5.1, spécialisé en code et science
Nouveau modèle d'Anthropic avec des progrès marqués en coding et benchmarks scientifiques, testé sur le "pelican benchmark".
Simon Willison·2 septembre 2026
Lu et jugé par Fellow · impact léger
Nouveau modèle avec benchmarks améliorés, mais l'article est un test informel du pelican benchmark par un blogueur indépendant.
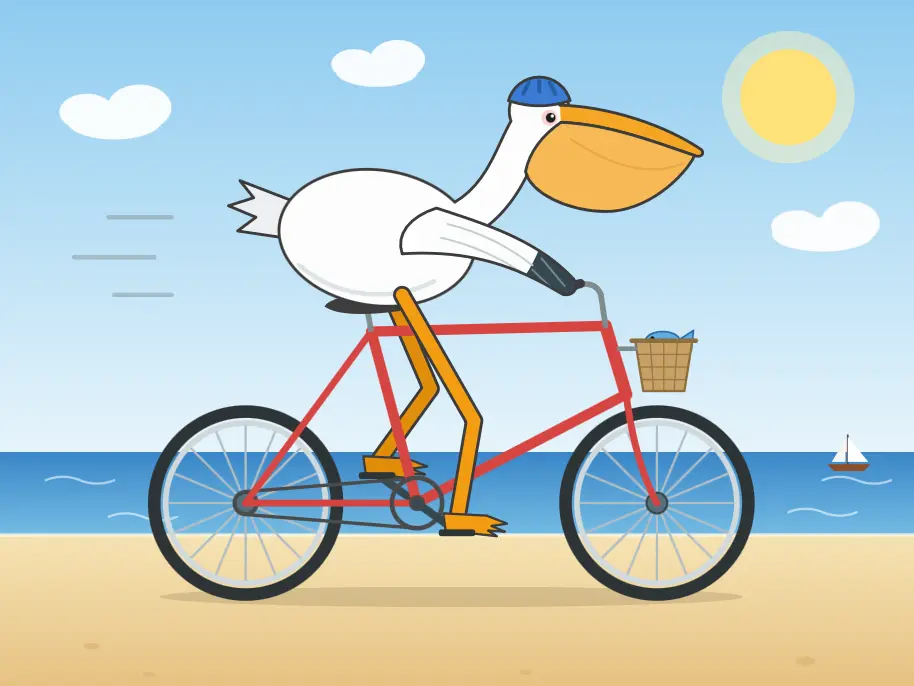
Image · Source originale
Anthropic annonce Claude Fable 5.1, un modèle qui excelle en codage et résolution de problèmes complexes. Il affiche un score de 52,6% sur le benchmark Terminal-Bench-Science 0.1, contre 24,7% pour Fable 5. L'auteur teste les cinq niveaux de raisonnement intégrés (low à max) via son propre benchmark visuel.
Traduit et résumé par IA à partir de l'article de Simon Willison ↗ · Comment Fellow travaille
Fiche Claude Fable 5.1 : prix API, sorties et articles
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Show HN : Gemini 4 Argon joue à StarCraft sur le benchmark StarSkirmish16 octobre 2026
- Reproductibilité et robustesse analytique en découverte scientifique grâce à l'IA16 octobre 2026
- Quant-Arena : un benchmark pour les agents LLM en recherche de trading quantitatif21 octobre 2026
- Anthropic dévoile Claude Fable 5.1 et Claude Mythos 5.1Anthropic · 1 septembre 2026
- Claude Fable/Mythos 5.1 : nouveau SOTA, cache 75% moins cher mais 70% plus de tokens en sortie2 septembre 2026
- Stepfun dévoile Step 5 Preview, nouveau LLM sur la frontière de Pareto19 septembre 2026