OpenAI dévoile son architecture réseau pour superordinateurs d'entraînement IA à grande échelle
OpenAI publie les détails de son infrastructure réseau haute performance conçue pour accélérer l'entraînement de modèles d'IA à très grande échelle.

Traduit et résumé par IA à partir de l'article d'OpenAI ↗ · Comment Fellow travaille
Développement
· Généré par Claude Sonnet 4.6↓ LIRE LE DÉVELOPPEMENT · 3 MIN← MASQUER LE DÉVELOPPEMENT
L'entraînement de modèles de grande envergure repose sur la coordination de dizaines ou centaines de milliers de GPU fonctionnant en mode synchrone. Chaque étape d'un entraînement peut mobiliser plusieurs millions de transferts de données : un seul paquet arrivant en retard suffit à immobiliser l'ensemble du cluster. C'est ce problème fondamental qu'OpenAI a cherché à résoudre en développant MRC, pour Multipath Reliable Connection, un nouveau protocole réseau aujourd'hui rendu public via l'Open Compute Project (OCP).
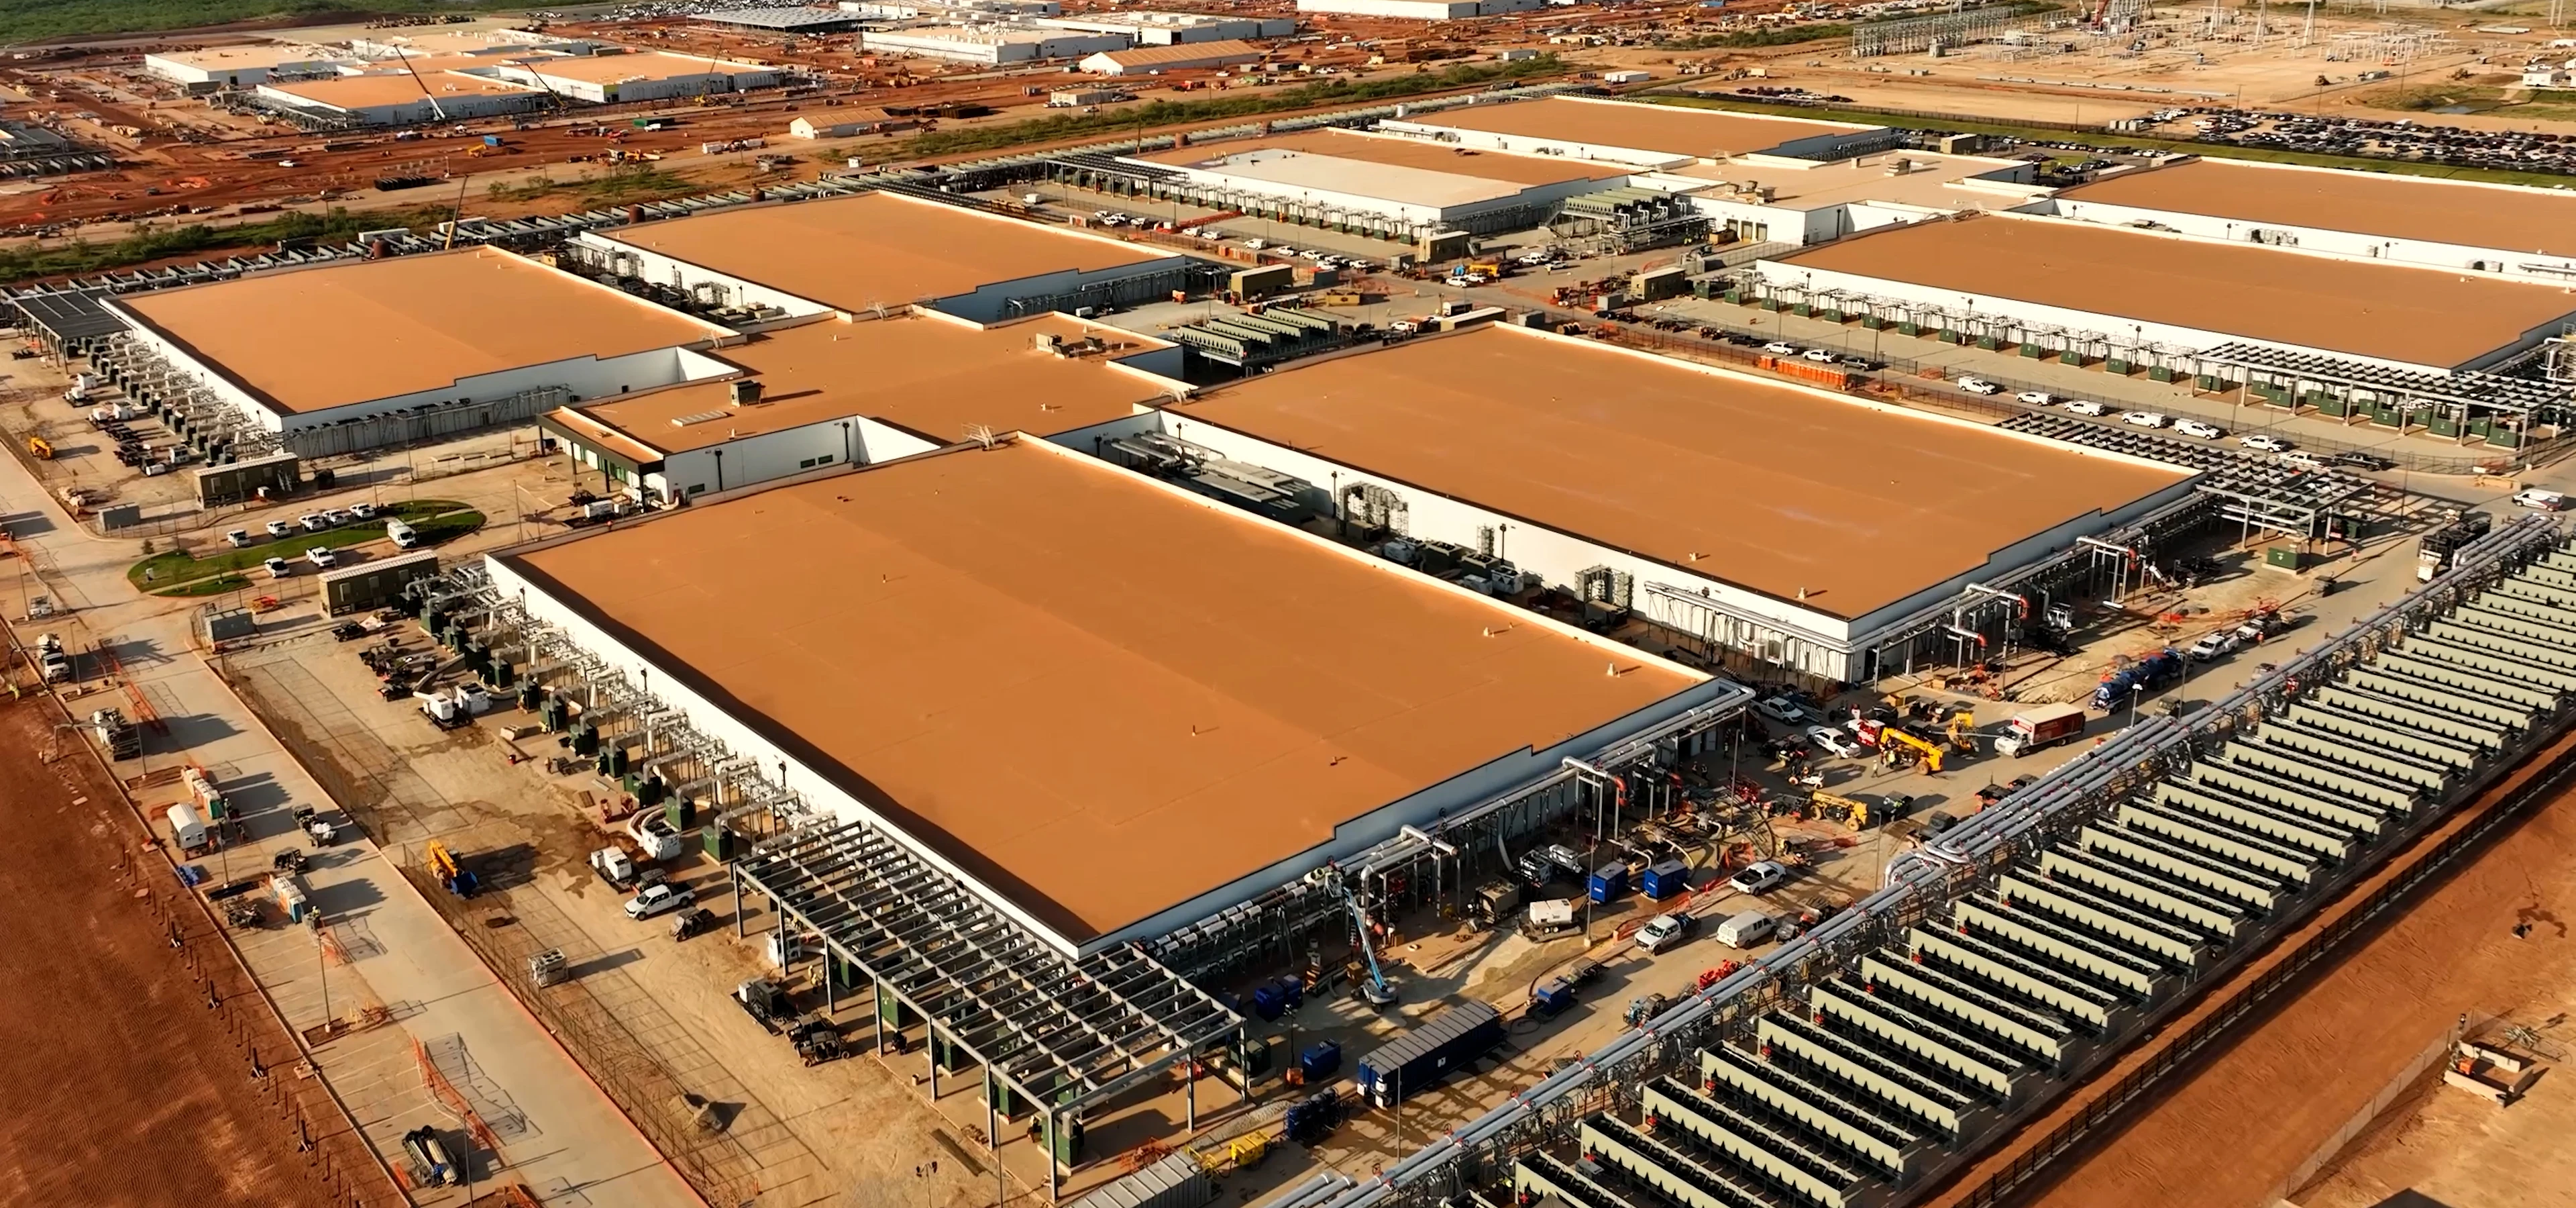
Le protocole a été conçu en collaboration avec AMD, Broadcom, Intel, Microsoft et NVIDIA sur une période de deux ans. Il est d'ores et déjà déployé sur l'ensemble des superordinateurs NVIDIA GB200 d'OpenAI, notamment sur le site Stargate opéré par Oracle Cloud Infrastructure (OCI) à Abilene, au Texas, ainsi que sur les superordinateurs Fairwater de Microsoft. Plusieurs modèles frontières ont d'ores et déjà été entraînés sur cette infrastructure.
Le premier apport de MRC concerne la topologie réseau dite multi-plane. Plutôt que d'utiliser chaque interface réseau comme un lien unique à 800 Gb/s, l'architecture divise ce lien en plusieurs liens plus étroits, par exemple huit liens à 100 Gb/s chacun, chacun connecté à un switch distinct. On obtient ainsi huit réseaux parallèles indépendants. Cette approche permet de connecter plus de 130 000 GPU avec seulement deux niveaux de switches, là où une architecture conventionnelle en nécessiterait trois ou quatre. Le gain est triple : réduction du nombre de composants susceptibles de tomber en panne, consommation électrique moindre, et coût total inférieur.
Le second mécanisme central est le packet spraying adaptatif. Contrairement aux protocoles classiques RoCE (RDMA over Converged Ethernet) qui forcent chaque flux à emprunter un chemin unique pour garantir l'ordre d'arrivée des paquets, MRC distribue les paquets d'un même transfert sur des centaines de chemins simultanément. Chaque paquet transporte directement son adresse mémoire de destination, ce qui permet de les réassembler à l'arrivée sans attendre un ordre séquentiel. Ce mécanisme élimine en pratique les points de congestion dans le cœur du réseau. Si un chemin devient congestionné, MRC le remplace automatiquement ; si un paquet est perdu, le protocole abandonne immédiatement le chemin défaillant et retransmet les données par un autre itinéraire. Une technique complémentaire dite de packet trimming permet par ailleurs de distinguer les pertes dues à une congestion de celles causées par une véritable défaillance : un switch saturé ne supprime pas le paquet entier mais en retire la charge utile, transmettant uniquement l'en-tête pour déclencher une retransmission explicite.
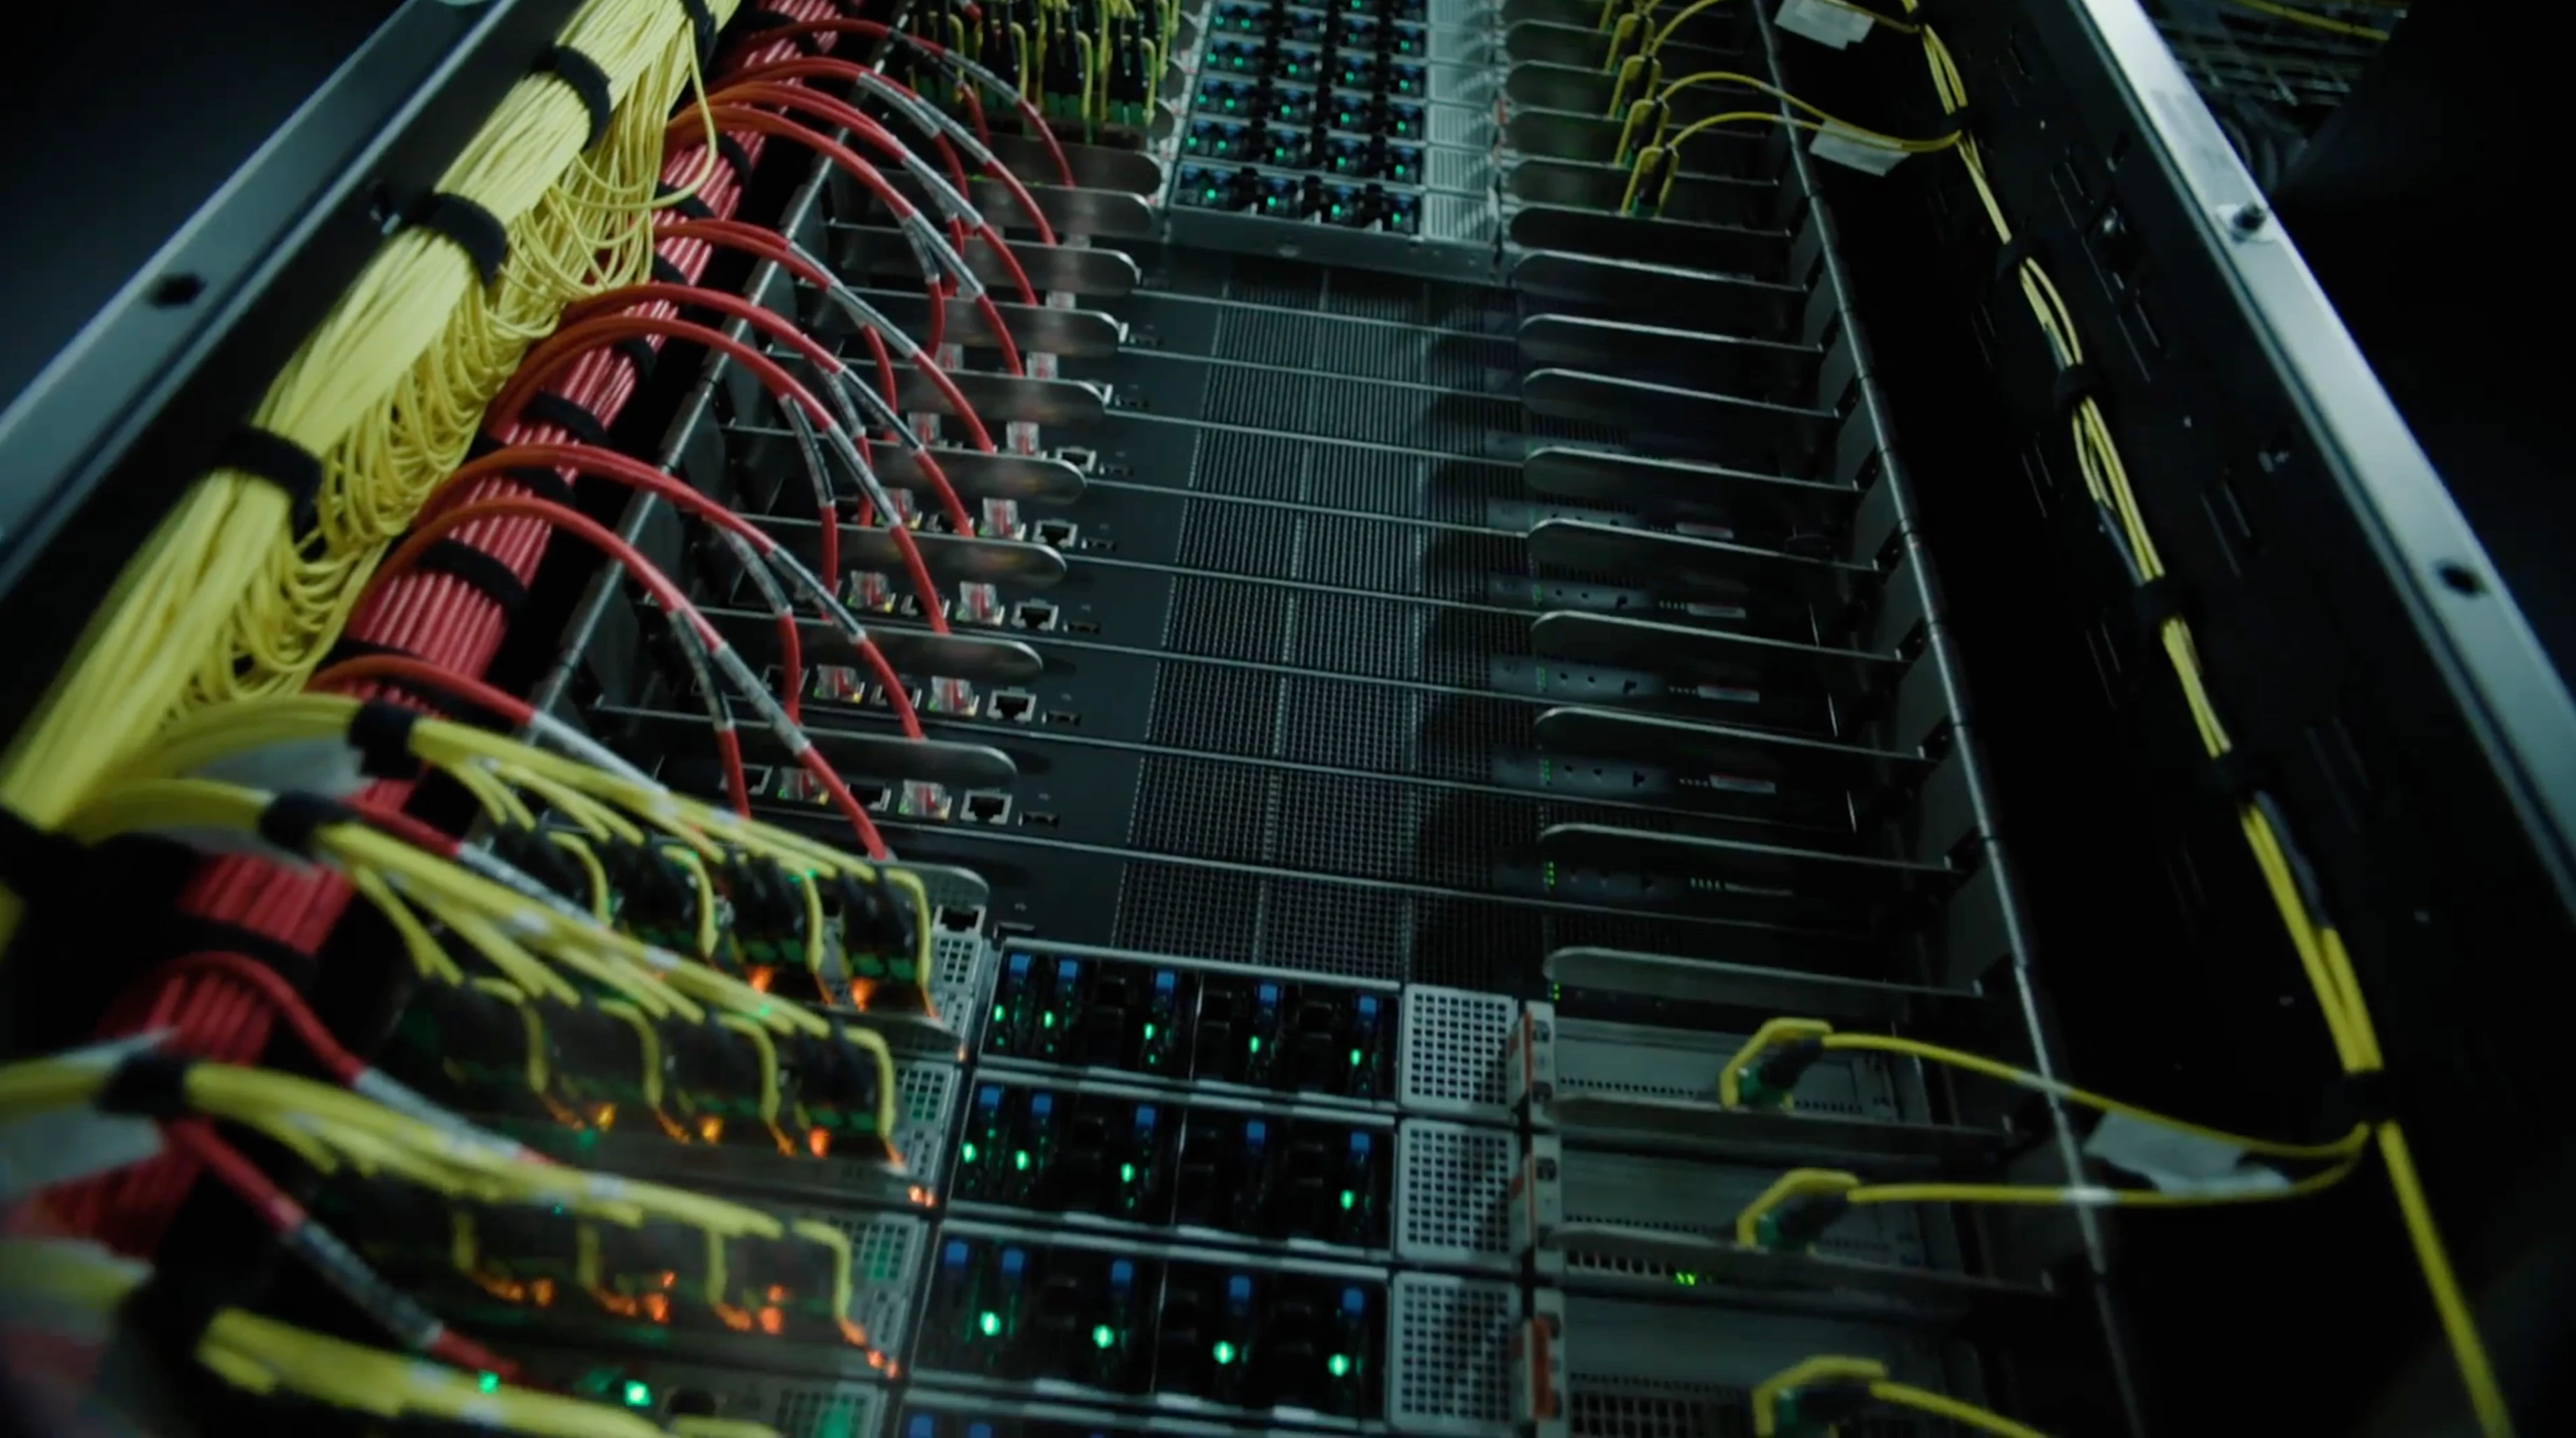
Le troisième pilier est l'abandon du routage dynamique au profit du source routing via IPv6 Segment Routing (SRv6). Dans une architecture traditionnelle, les switches exécutent des protocoles dynamiques comme BGP pour recalculer les routes en temps réel — un processus qui peut prendre plusieurs secondes en cas de défaillance. Avec SRv6, c'est l'émetteur lui-même qui spécifie l'intégralité du chemin dans l'en-tête de chaque paquet, en encodant la séquence des identifiants de switches à traverser. Les tables de routage des switches deviennent statiques et ne sont plus jamais modifiées après leur configuration initiale. En cas de panne d'un lien ou d'un switch, MRC cesse simplement d'utiliser les chemins concernés, sans que les équipements réseau n'aient à recalculer quoi que ce soit.
Les résultats en production illustrent l'efficacité de l'approche. Des fluctuations répétées de liens entre switches de niveaux 0 et 1 — plusieurs par minute — n'ont eu aucun impact mesurable sur les jobs d'entraînement synchrone. Le redémarrage de quatre switches de niveau 1 pendant l'entraînement d'un modèle frontier récent n'a nécessité aucune coordination avec les équipes en charge des jobs. Avant MRC, une telle opération aurait exigé une planification soigneuse pour éviter l'interruption de l'entraînement ou une reprise depuis un checkpoint.
La mise à disposition de la spécification MRC via l'OCP soulève plusieurs questions pour l'ensemble de l'industrie. L'adoption de ce standard par d'autres opérateurs de clusters pourrait accélérer l'interopérabilité à grande échelle et réduire la dépendance à des solutions propriétaires. La question de l'intégration avec les futures générations de hardware réseau, notamment au-delà du 800 Gb/s, reste ouverte, de même que l'extension possible de MRC à des workloads d'inférence distribués, aujourd'hui non mentionnés dans la publication.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Faire évoluer rapidement le stockage en ligne pour plus d'un milliard d'utilisateurs de ChatGPT (partie II)OpenAI · 23 octobre 2026
- OpenAI détaille ses priorités et principes pour des évaluations tierces efficacesOpenAI · 22 septembre 2026
- Higgsfield AI déploie de nouvelles fonctions vidéo en un jour grâce à GPT-6 AstraOpenAI · 21 septembre 2026
- OpenAI : lettre au gouverneur Abbott pour une IA responsableOpenAI · 10 août 2026
- OpenAI détaille sa stratégie pour une « intelligence abondante »OpenAI · 31 juillet 2026
- OpenAI dévoile Project Camellia, un site d'infrastructure IA en GéorgieOpenAI · 22 juillet 2026