OUTILS
Verdict : légerUn modèle de 8,6 Go limité à 7 requêtes par seconde
L'analyse détaillée des goulets d'étranglement qui entravent le débit d'inférence.
mapathak-commits.github.io·repéré via Hacker News·26 août 2026
Lu et jugé par Fellow · impact léger
Étude de cas technique documentée et vérifiable, mais portée limitée à un cas d'optimisation d'inférence sur une seule GPU.
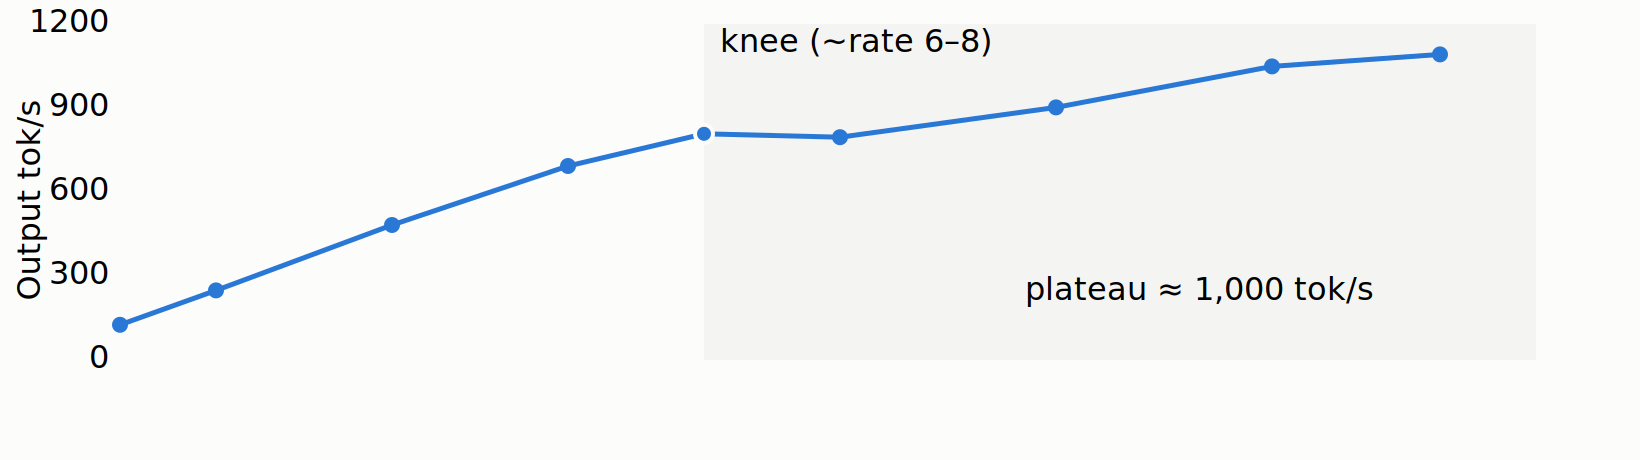
Image · Source originale
Cette étude de cas technique identifie les goulots d'étranglement matériels et logiciels limitant le débit d'un modèle de 8,6 Go à seulement 7 requêtes par seconde. L'article dissèque les coûts de latence et propose des pistes d'optimisation.
Traduit et résumé par IA à partir de l'article de mapathak-commits.github.io ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Faire tourner Qwen 3.8 Flash Next (125B) sur du matériel grand public (RTX 4090) à 100 T/s4 octobre 2026
- DeepSeek-V4.1-Flash : repousser les limites de la compression du cache KVDeepSeek · 1 octobre 2026
- Un décodage spéculatif par recherche de motifs plus rapide dans llama.cpp26 septembre 2026
- Réduire de 90% le coût CPU d'eBPF par mémoïsation14 septembre 2026
- La frontière d'efficacité de l'inférence LLM2 septembre 2026
- Para-Pipe : parallélisme hiérarchique sur SoC3 septembre 2026