OUTILS
Verdict : légerPourquoi votre LLM local semble plus bête qu'il ne l'est réellement
Un article de forum décortique les réglages techniques négligés qui plombent silencieusement les performances des LLM exécutés en local.
forum.level1techs.com·repéré via Hacker News·22 août 2026
Lu et jugé par Fellow · impact léger
Article de forum sur des réglages techniques déjà connus, sans nouveauté ni donnée vérifiable.
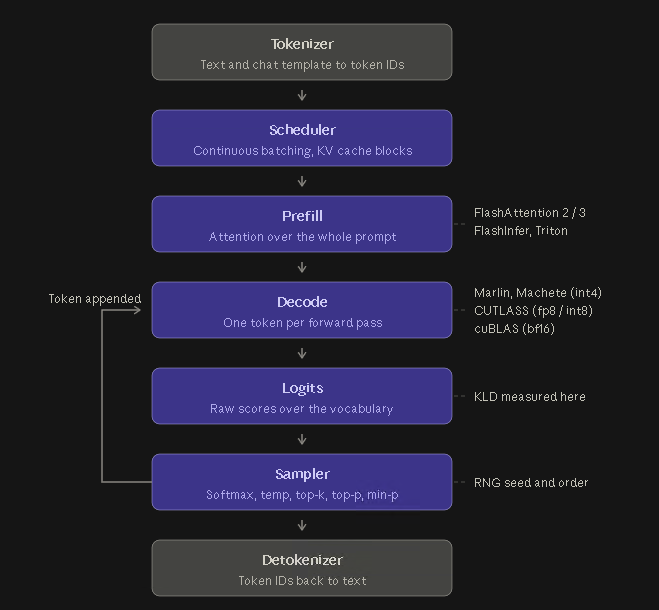
Image · Source originale
L'article explique que la médiocrité perçue des LLM locaux vient souvent de paramètres mal configurés (quantification, context window, sampling, templates de prompt) plutôt que d'une limite intrinsèque du modèle. Il détaille plusieurs pièges courants qui dégradent la qualité des réponses sans que l'utilisateur s'en aperçoive.
Traduit et résumé par IA à partir de l'article de forum.level1techs.com ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Show HN : Capy-flash, un modèle MoE de 125 Md de paramètres sur deux GPU grand public de 16 Go16 octobre 2026
- L'IA capable de concevoir son propre matériel d'inférence : le projet openTPU6 octobre 2026
- FuTransformer : prefill FP8 et decode INT4 pour l'inférence de type Llama sur Hopper16 octobre 2026
- Xiaomi AI Cube et Xring O100 : 1,22 To/s, 330 tokens/s pour un LLM local de 120B24 août 2026
- Un outil permet de faire tourner Qwen3.8 27B sur des GPU Nvidia de 16 Go17 septembre 2026
- Nunchaku : inférence 4-bit pour diffusion dans DiffusersHugging Face · 23 juillet 2026