Portal by Spotify réduit l'usage de tokens Claude Code de 90%
L'outil interne de Spotify optimise drastiquement la consommation de tokens pour les assistants de code.
Lu et jugé par Fellow · impact notable
Plugin open source fournissant une implémentation concrète de routage de modèles avec benchmark propre justifiant les 90% d'économie.
Traduit et résumé par IA à partir de l'article d'engineering.atspotify.com ↗ · Comment Fellow travaille
Développement
· Généré par GLM 4.7↓ LIRE LE DÉVELOPPEMENT · 2 MIN← MASQUER LE DÉVELOPPEMENT
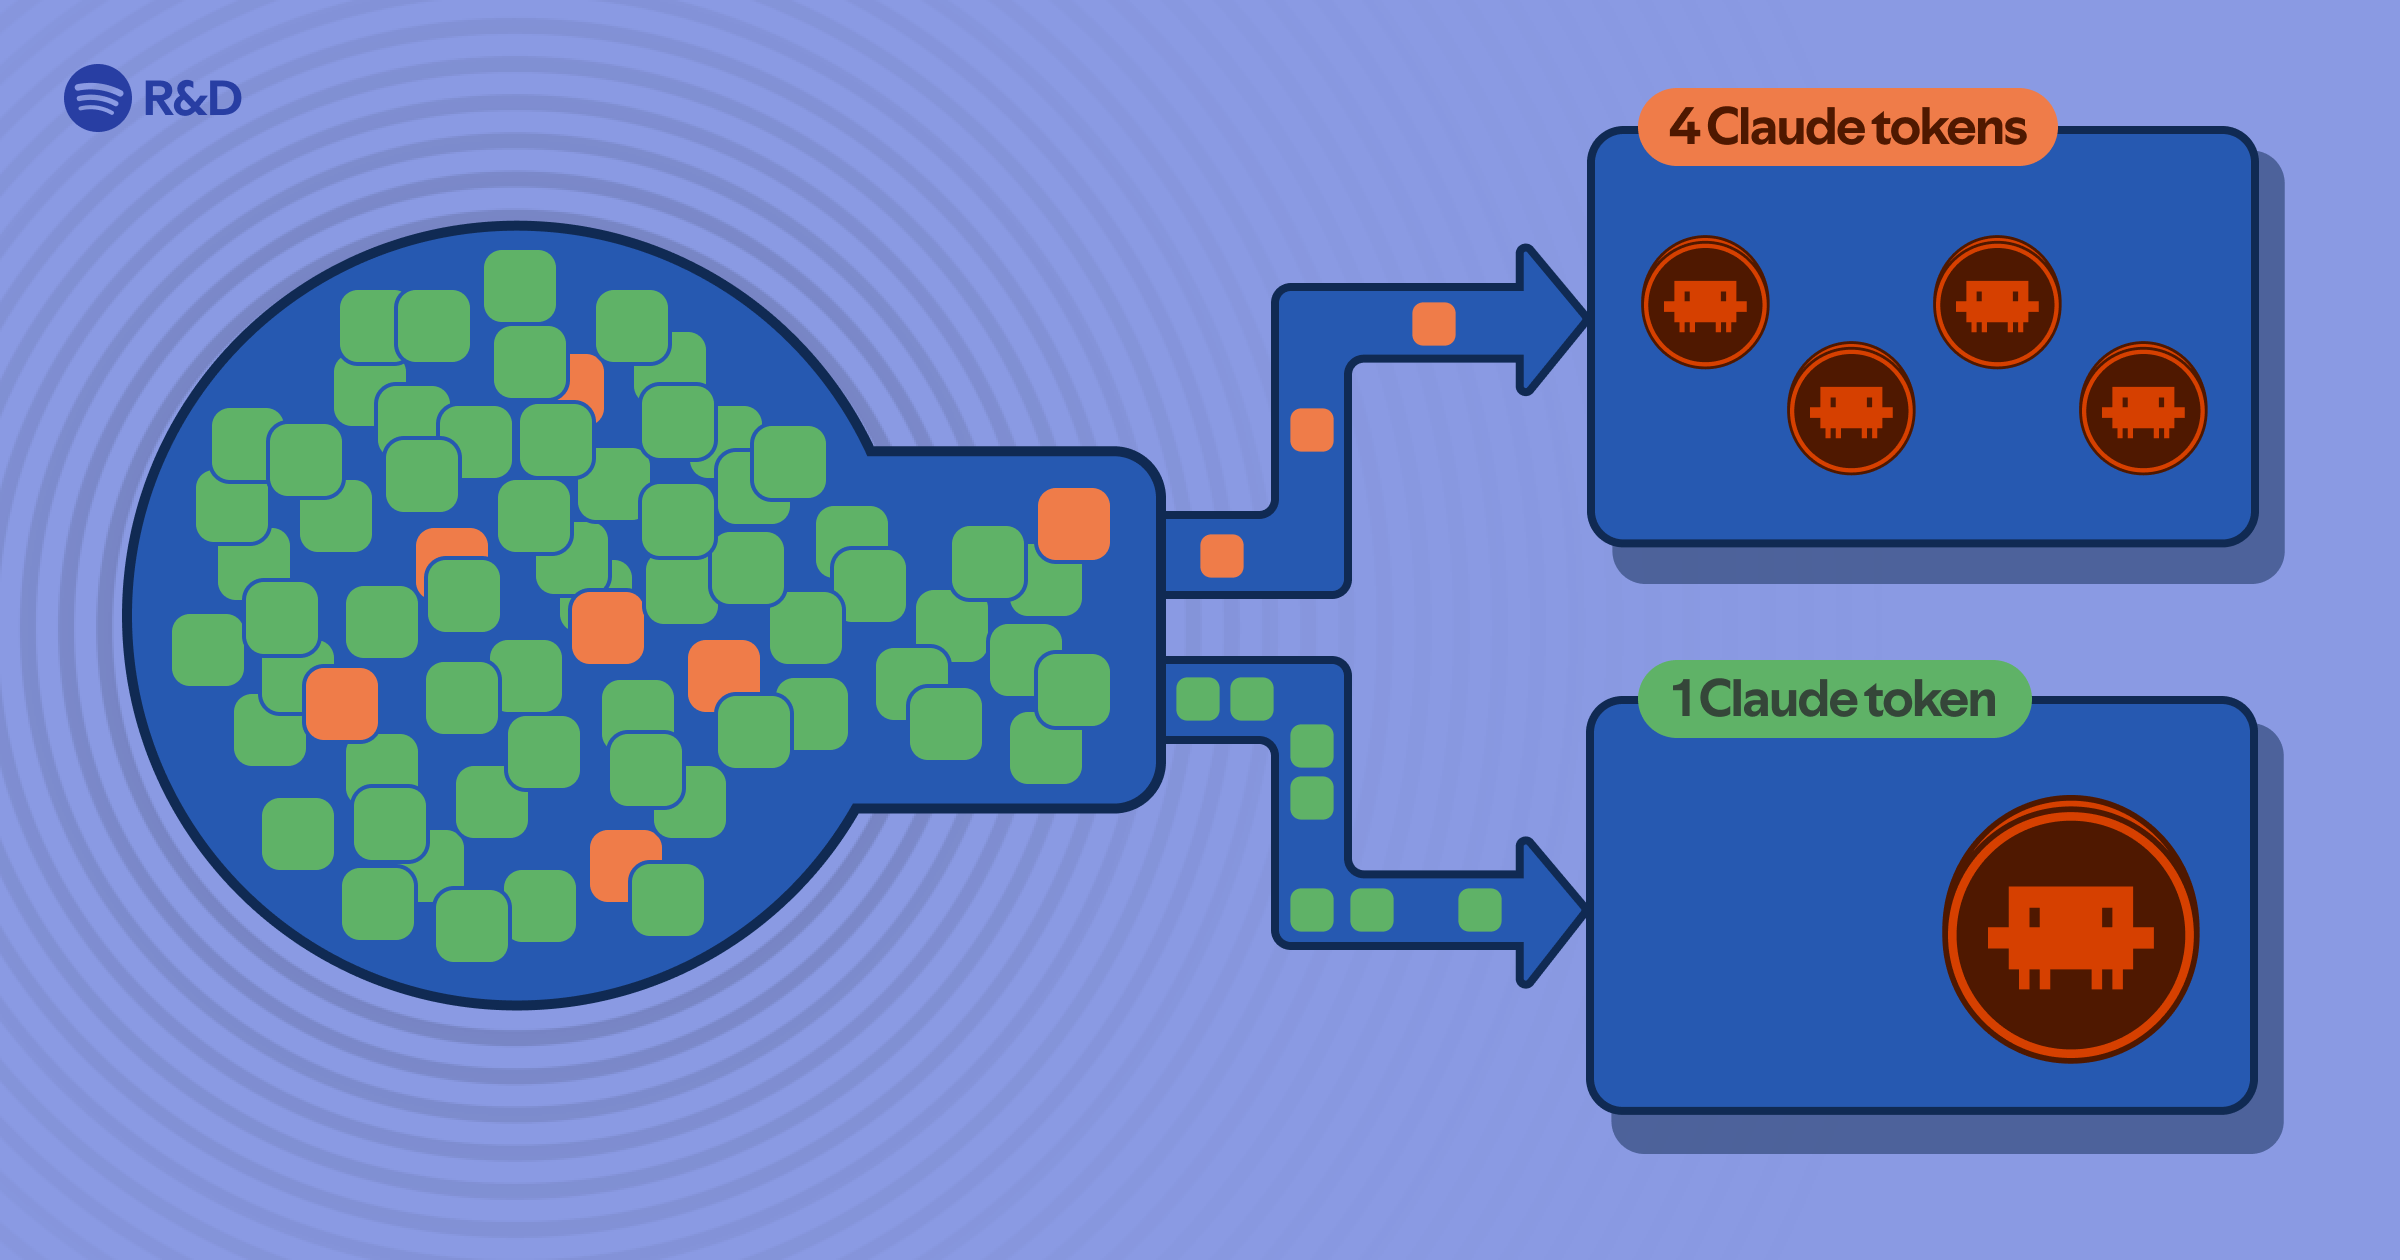
L'optimisation des coûts liés aux grands modèles de langage (LLM) devient une préoccupation critique pour les directions techniques, alors que les prévisions estiment que les dépenses en IA générative pour le code pourraient dépasser le salaire moyen d'un développeur d'ici 2028. Dans ce contexte, Spotify a dévoilé Portal, une approche architecturale basée sur le "model routing" pour réduire drastiquement la consommation de tokens. L'idée centrale est de constater qu'une grande partie de l'activité d'un assistant de code consiste en des opérations d'entrées/sorties (I/O) et de génération prévisible, tâches pour lesquelles l'utilisation de modèles frontaux coûteux et puissants est superflue.
La solution repose sur la création de "modes", des agents déclaratifs exécutés sur un runtime éphémère, comparables à des fonctions AWS Lambda mais pour les agents d'IA. Dans le cas d'usage présenté, Spotify a configuré deux modes spécifiques délégués à un modèle worker plus économique, tel que Gemini 2.5 Flash. Le premier mode, "bulk-reader", est conçu pour ingérer de multiples fichiers volumineux et synthétiser l'information sous forme de balises structurées, évitant ainsi au modèle principal de traiter des milliers de lignes de code inutiles. Le second, "code-writer", se concentre sur la génération de code standard (tests, configurations, stubs) en s'appuyant exclusivement sur des patrons existants, sans produire de prose explicative.
L'efficacité du système est garantie par une implémentation en trois couches, orchestrée par un plugin Claude Code nommé "shunt". La première couche utilise des "hooks" qui interceptent les appels d'outils : si la taille d'un fichier dépasse un seuil configurable (par défaut 350 lignes), l'accès direct est bloqué. La deuxième couche repose sur des scripts bash qui encapsulent les appels vers l'interface en ligne de commande (CLI) de Portal, assurant la transmission des fichiers et des spécifications vers le mode approprié. Enfin, une troisième couche de "skills" guide l'IA vers la bonne commande lorsque le blocage est déclenché. Cette architecture permet une dégradation gracieuse du système : même si l'IA ne suit pas parfaitement les instructions, les hooks mécaniques empêchent la consommation inutile de tokens coûteux.
Les benchmarks menés sur un monorepo Java démontrent l'efficacité de cette méthode, avec une réduction moyenne de la consommation de tokens de l'ordre de 90 % pour les opérations de lecture en masse. Pour l'écriture de code, l'économie est plus difficile à mesurer directement, mais substantielle, car le code généré par le modèle worker est écrit directement sur le disque sans jamais entrer dans le contexte du modèle principal. Les modes sont réutilisables, partageables au sein de l'entreprise et composables, permettant potentiellement d'étendre le concept à d'autres domaines comme la documentation ou l'internationalisation.
Cependant, cette approche comporte des limitations inhérentes qu'il est crucial de considérer. La délégation ne fonctionne pas pour l'édition de code, car les résumés du modèle worker ne fournissent pas des numéros de ligne fiables pour appliquer des correctifs ciblés. De même, le raisonnement complexe ne peut être délégué : lors des tests, un modèle worker a manqué un bug subtil de concurrence que le modèle principal a identifié immédiatement. Par conséquent, le système exclut explicitement le débogage, les décisions architecturales et le code critique pour la sécurité. Enfin, la latence introduite par ces allers-retours réseau supplémentaires (10 à 30 secondes) rend la délégation contre-productive pour les fichiers de petite taille, d'où l'importance de régler correctement les seuils de déclenchement.
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Faire tourner Qwen 3.8 Flash Next (125B) sur du matériel grand public (RTX 4090) à 100 T/s4 octobre 2026
- Anthropic lance Claude Haiku 5.5, son modèle léger le plus rapideAnthropic · 7 octobre 2026
- Prédire la performance des agents de code post-entraînés à partir des modèles de base7 octobre 2026
- RoofLang : architecture de systèmes d'inférence LLM pilotée par l'IA14 septembre 2026
- Le nouveau system prompt de Claude refuse catégoriquement de reproduire des paroles de chansons2 septembre 2026
- NVIDIA détaille l'accélération de l'inférence LLM via le decoding spéculatifNVIDIA · 2 septembre 2026