OPINION
Votre modèle connaît déjà la réponse : comment les benchmarks fuitent dans les LLM
Une analyse pointe la contamination des données d'entraînement par les réponses des benchmarks, faussant l'évaluation réelle des performances des LLM.
elman.ai·repéré via Hacker News·5 août 2026
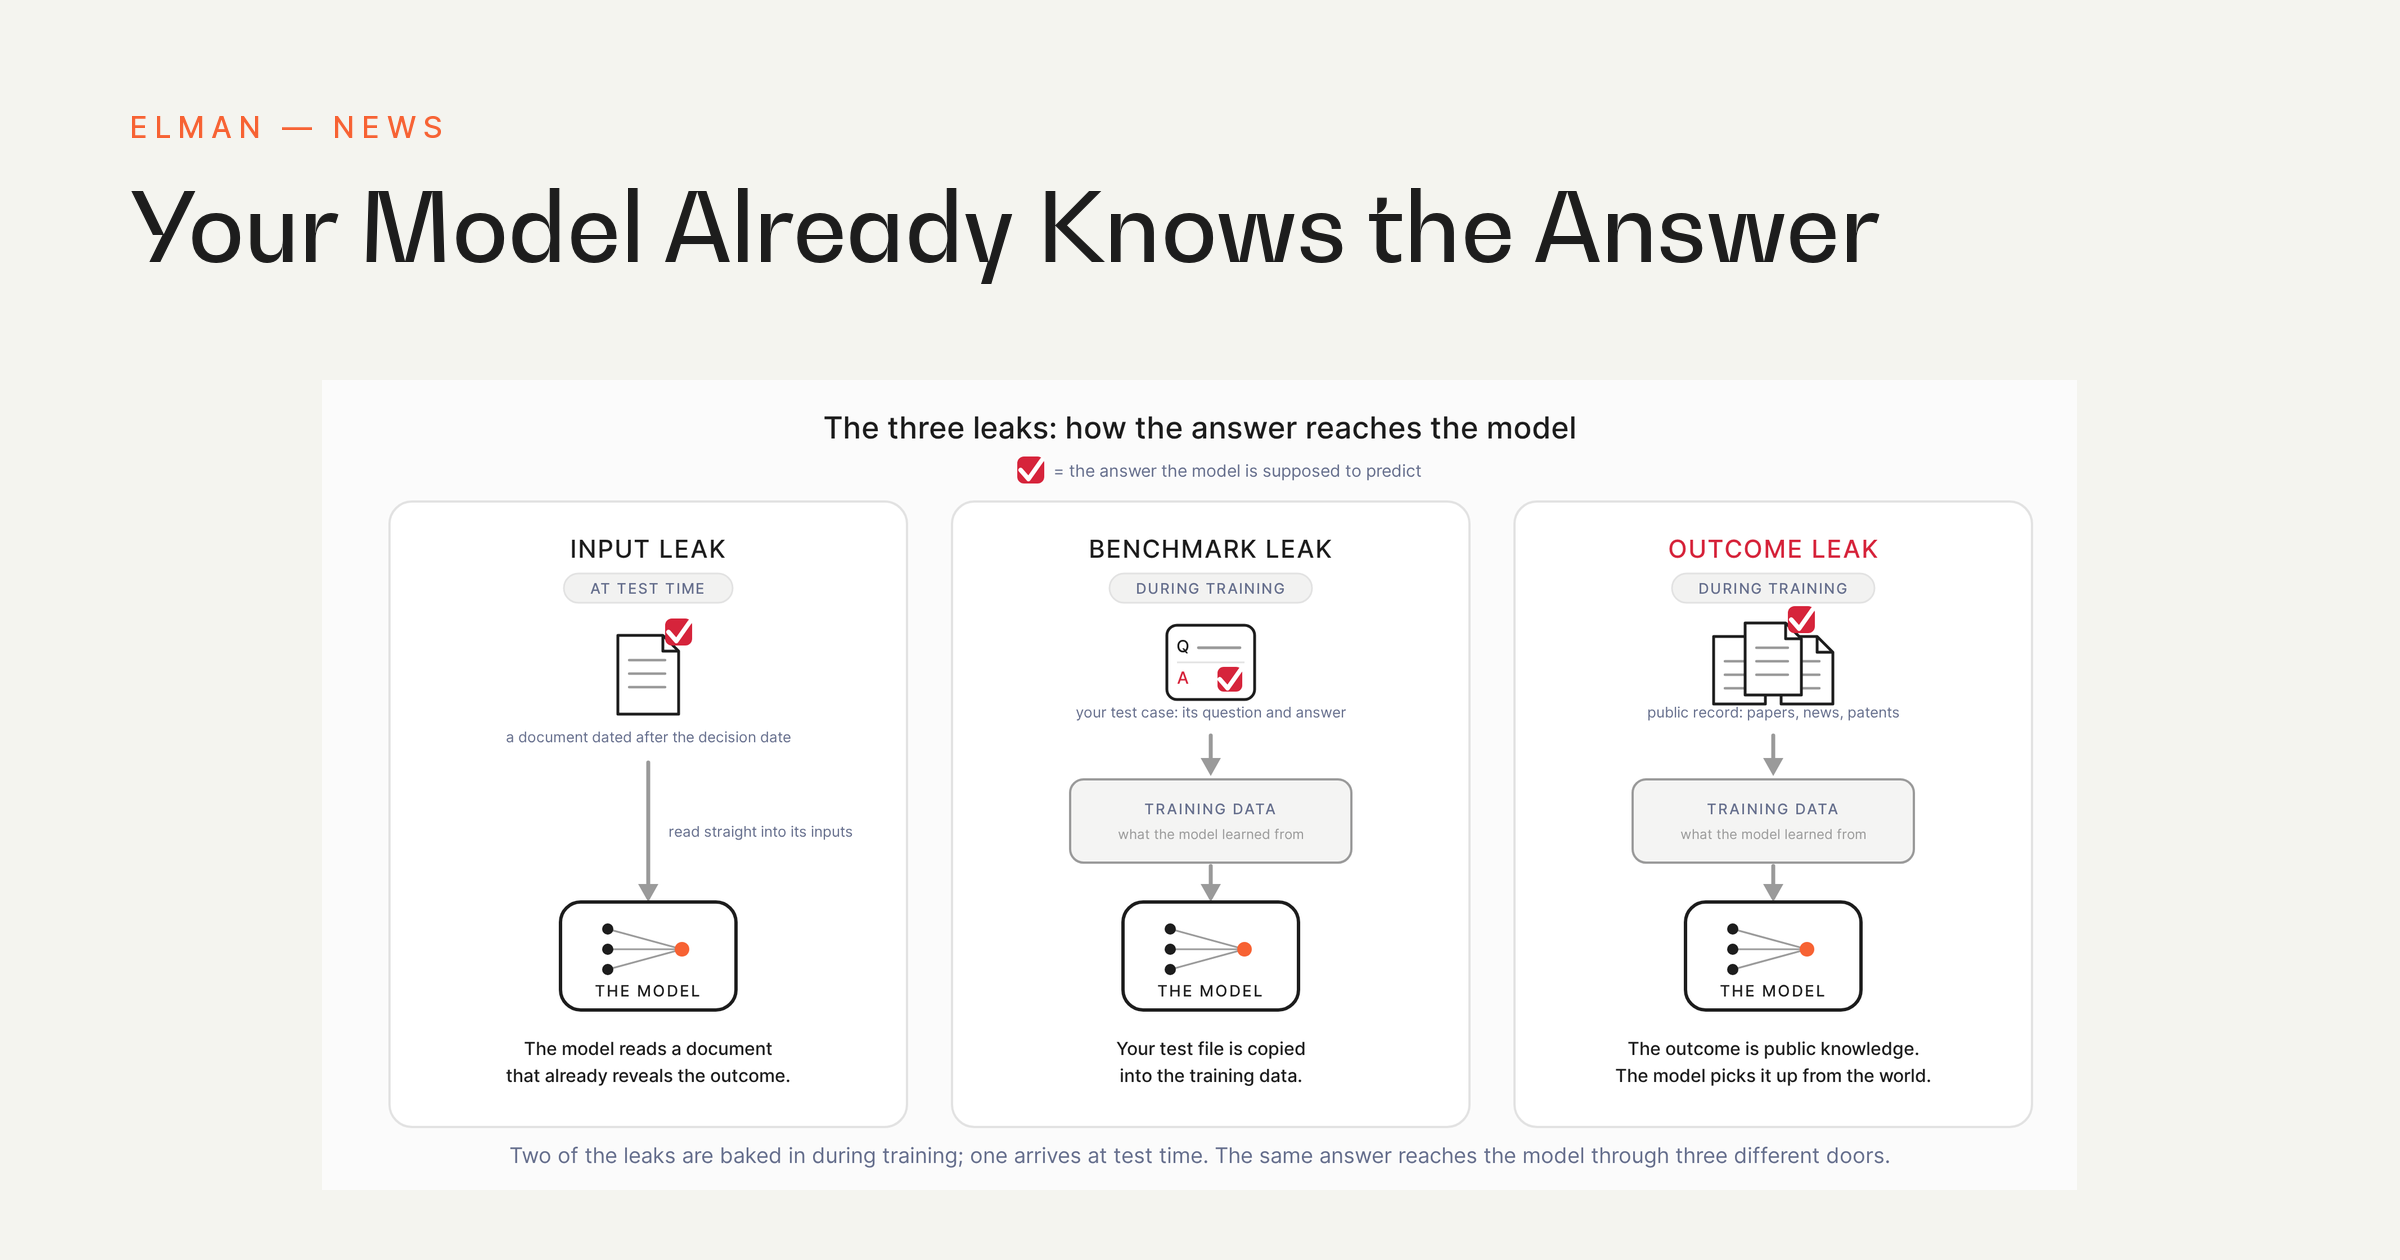
Image · Source originale
L'article examine comment les réponses aux benchmarks standards se retrouvent dans les corpus d'entraînement des LLM, biaisant artificiellement les scores obtenus. Cette contamination des données remettrait en cause la fiabilité de nombreux résultats de benchmarks publiés. L'auteur propose des pistes pour détecter et limiter ce phénomène.
Traduit et résumé par IA à partir de l'article d'elman.ai ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- Riches en valeurs, organisées autrement : mesurer l'expression et l'organisation des valeurs dans les débats générés par IA20 octobre 2026
- 90 % des heures de travail américaines portent sur des tâches mal couvertes par les benchmarks d'IA16 octobre 2026
- Environment Duels : un microcosme de la co-évolution des LLM21 octobre 2026
- Real-SWE : benchmark IA sur code d'entreprise privé12 septembre 2026
- Fuse : raisonnement social vérifiable pour assistants LLM15 septembre 2026
- Date de sortie et cutoff d'entraînement de 20 modèles d'IA16 septembre 2026