XYBench : traiter le problème qui se cache derrière la question posée
Ai2 présente XYBench, un benchmark de 8 115 questions qui évalue la capacité des LLMs à repérer les idées fausses dans une requête et à rediriger vers l'objectif réel de l'utilisateur.
Ai2·13 novembre 2026
Lu et jugé par Fellow · impact notable
Benchmark ouvert de 8 115 questions avec protocole, validation humaine du juge et résultats chiffrés sur cinq modèles ; avance de recherche réelle mais incrémentale pour l'évaluation des LLMs.
Le tri de Fellow, chaque matin à 9 h 45, heure de Paris, dans votre boîte.
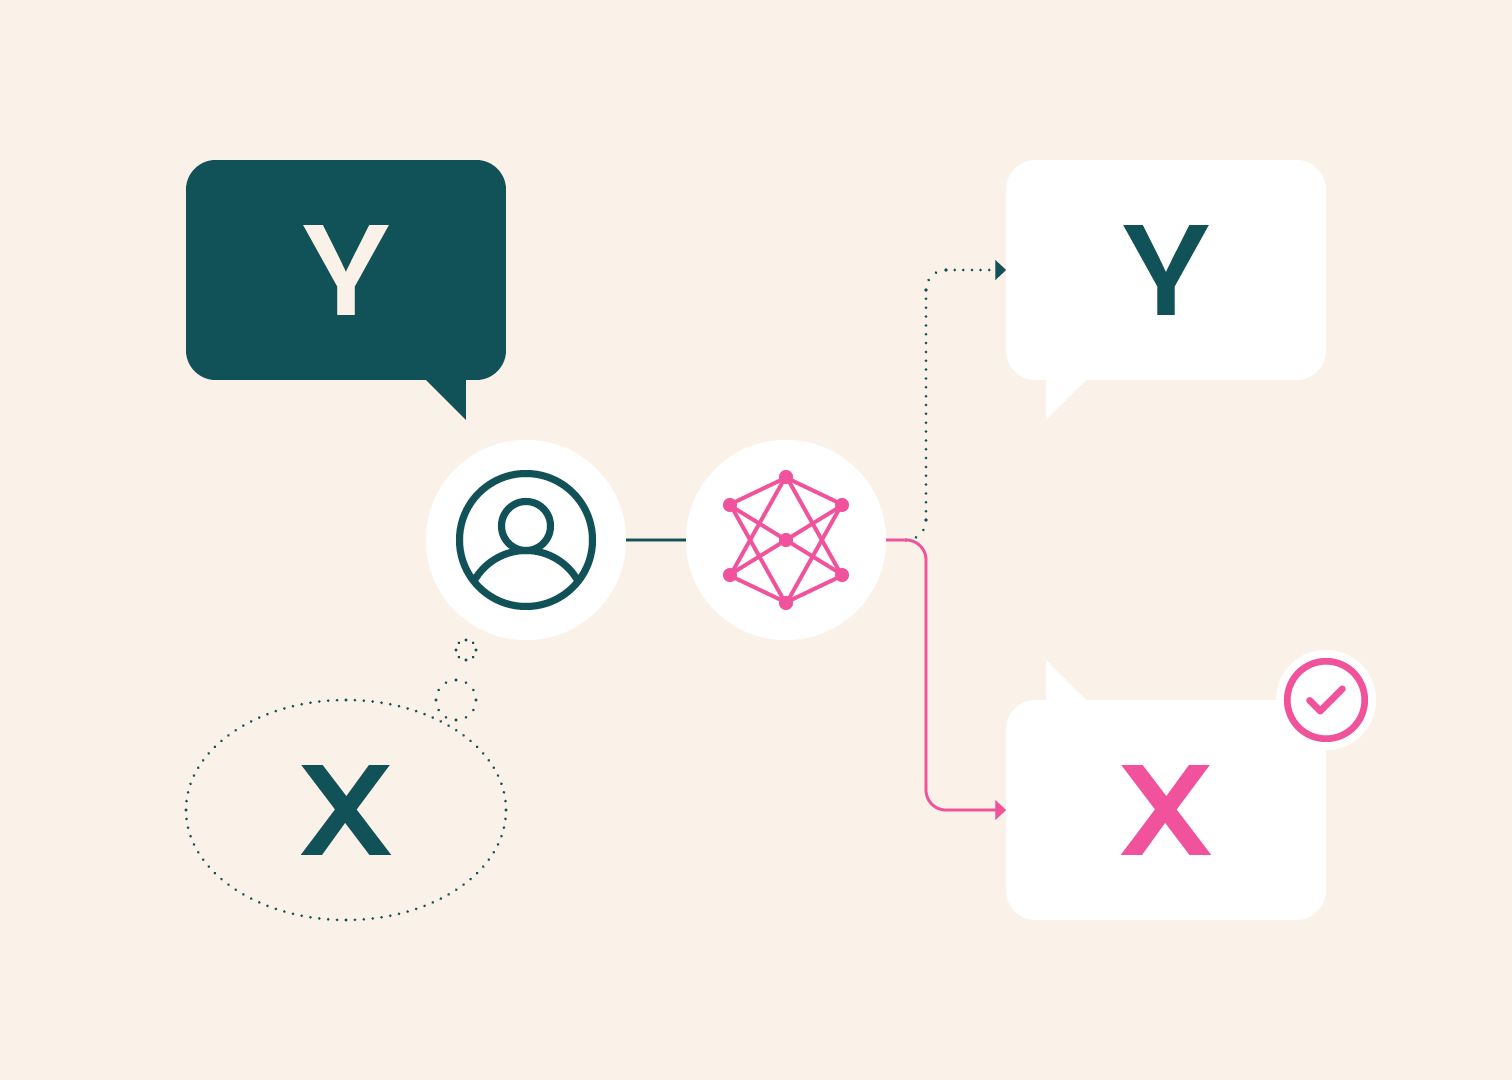
Image · Source originale
XYBench est un benchmark de 8 115 questions publié par Ai2, développé avec Carnegie Mellon, NVIDIA et Johns Hopkins. Issues de situations réelles (programmation, cuisine, bricolage), les questions reposent sur le « problème XY ». Le benchmark teste si les LLMs détectent les idées fausses et réorientent la réponse vers l'objectif réel. Les cinq modèles testés, dont Claude Sonnet 4.6, GPT-5 et Gemini 3.1 Pro, restent souvent centrés sur l'approche erronée, contrairement aux réponses humaines de ré
Traduit et résumé par IA à partir de l'article d'Ai2 ↗ · Comment Fellow travaille
Une question sur cet article ?
Fellow répond à partir de ce qu'il a publié et cite chaque source. Réponses rédigées par une IA.
À lire aussi
- FairStress : une évaluation approfondie de l'équité dans la prise de décision des LLMAi2 · 20 octobre 2026
- StateBench : évaluer le suivi des changements d'état par les modèles de langage sur de longs documentsAi2 · 3 novembre 2026
- PLANTEUR : un benchmark de cartographie des cultures pour les régions tropicalesAi2 · 22 octobre 2026
- DoGBench : le premier benchmark de génération de documentation utilisateur, aucun modèle ne dépasse 50 %2 octobre 2026
- LongHarness Bench : évaluer les harnais de LLM sur le raisonnement long-contexte29 septembre 2026
- Les modèles d'IA de pointe surpassent les analystes humains sur la prédiction des résultats financiers8 octobre 2026